图像语义分割 FCN 概念
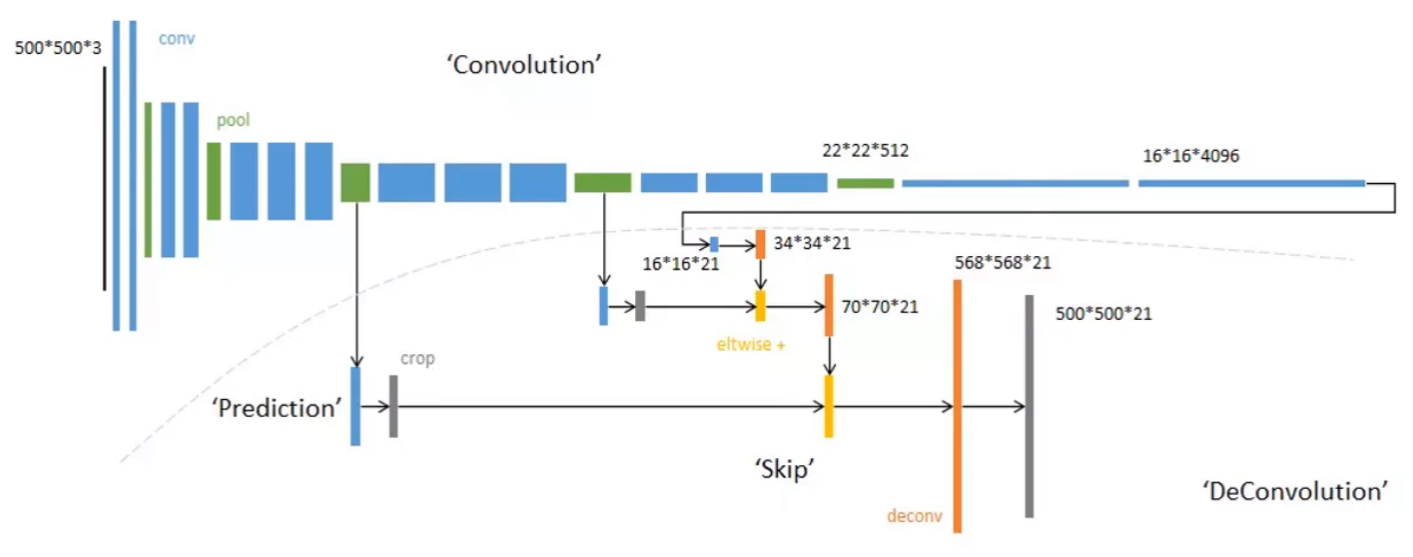
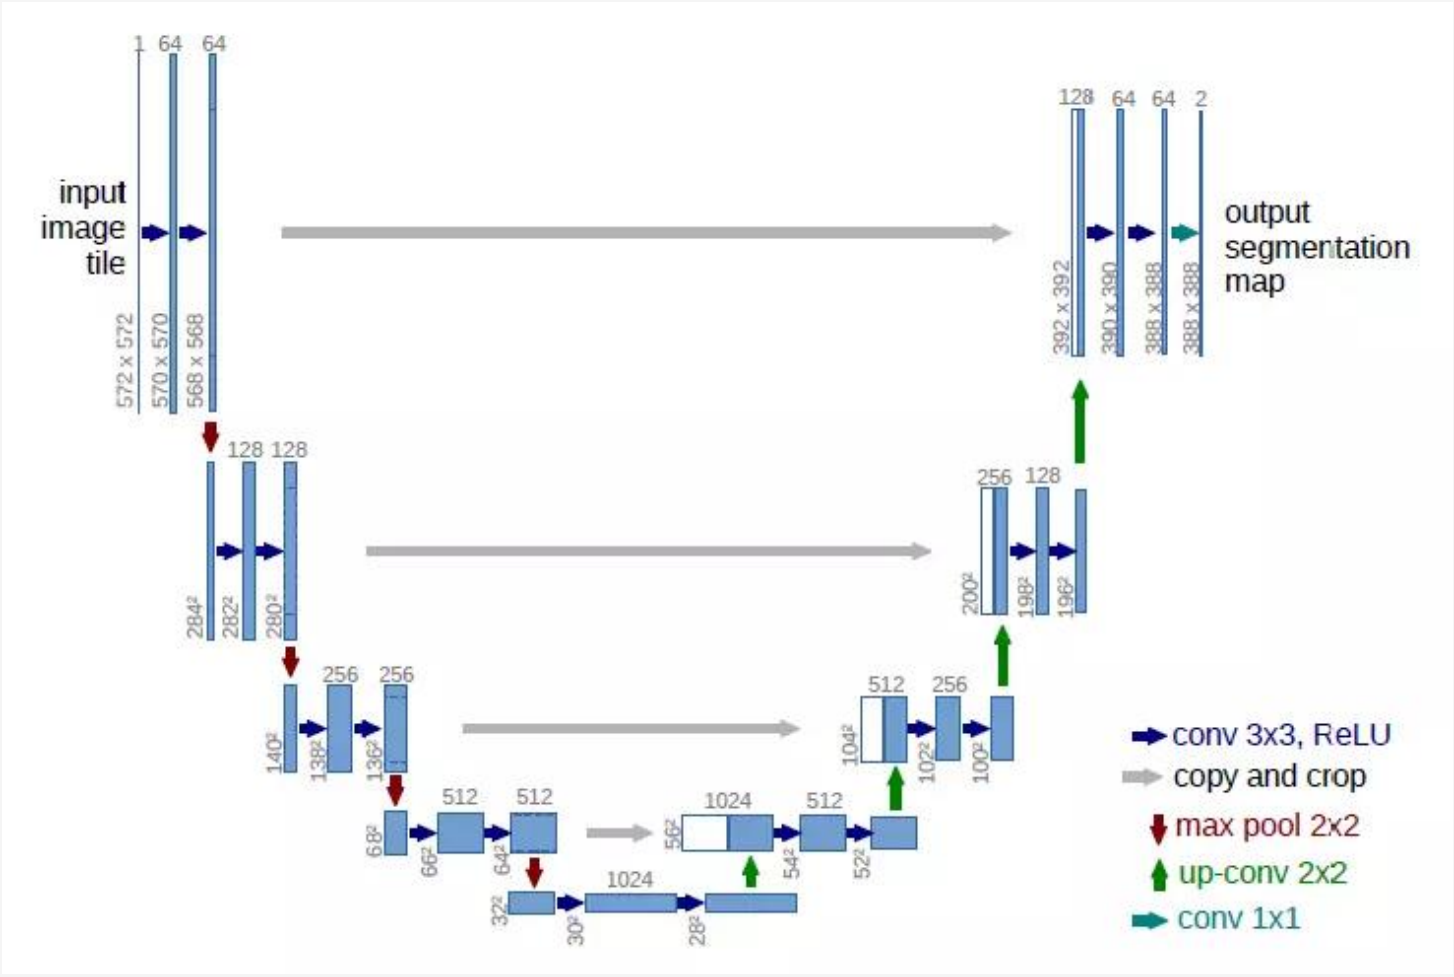
输入和输出
网络的输入可以为任意尺寸的彩色图像;
输出 与输入尺 寸相同,通道数为:n(目标类别数)+1(背景)。
全卷积
网络在CNN卷积部分不用全连接而是替换成卷积的目的 是允许输入的图片为超过某一尺寸的任意大小。
上采样 Upsampling
由于在卷积过程中,我们的特征图像变得很小(比如长宽变 为原图像的1/32),为了得到原图像大小的稠密像素预测, 我们需要进行上采样。
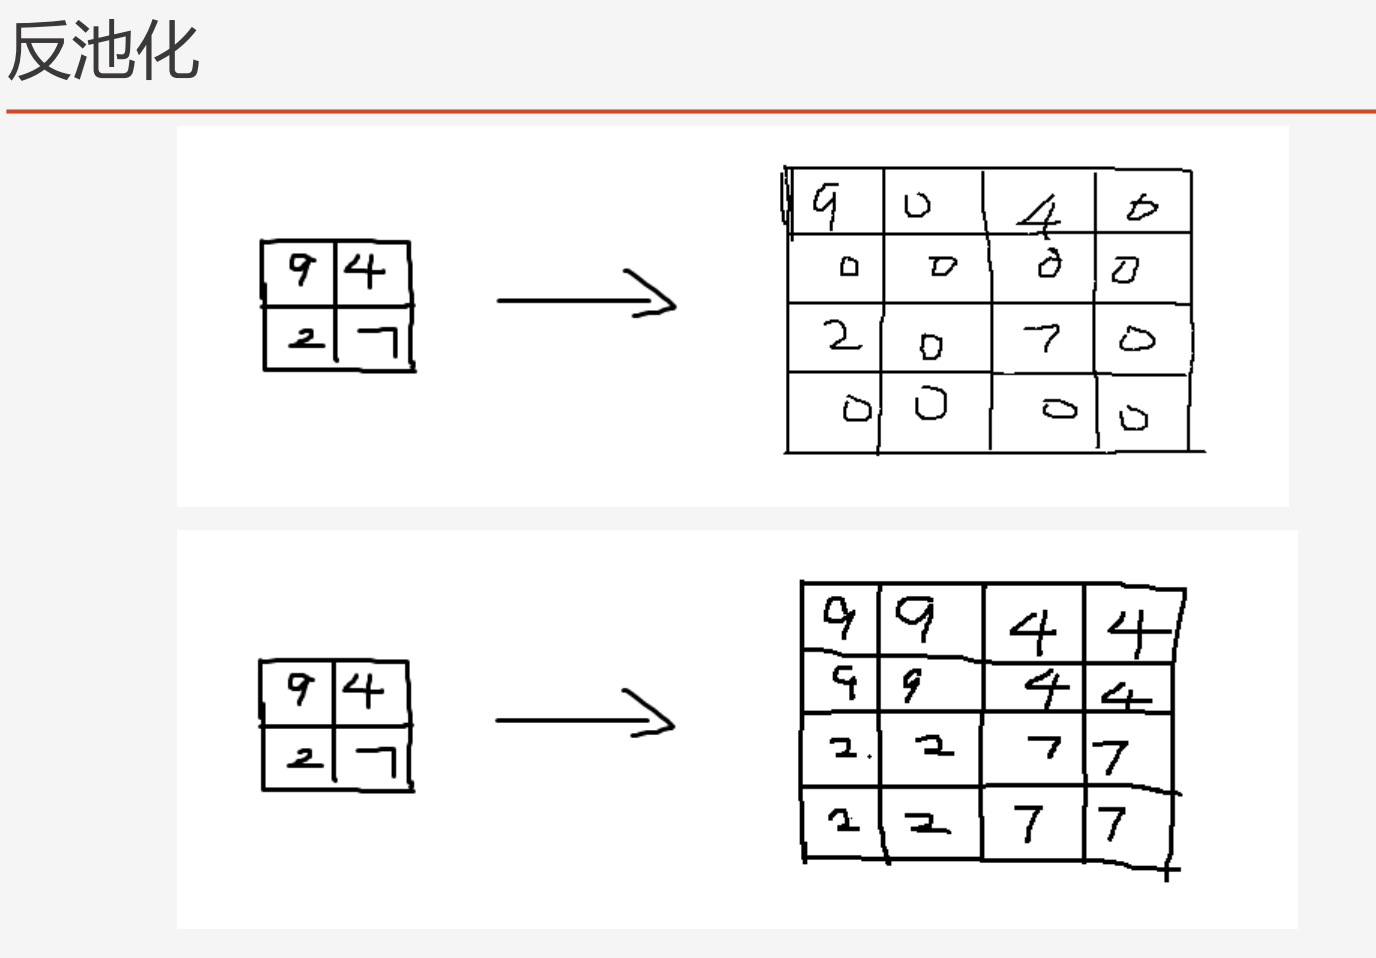
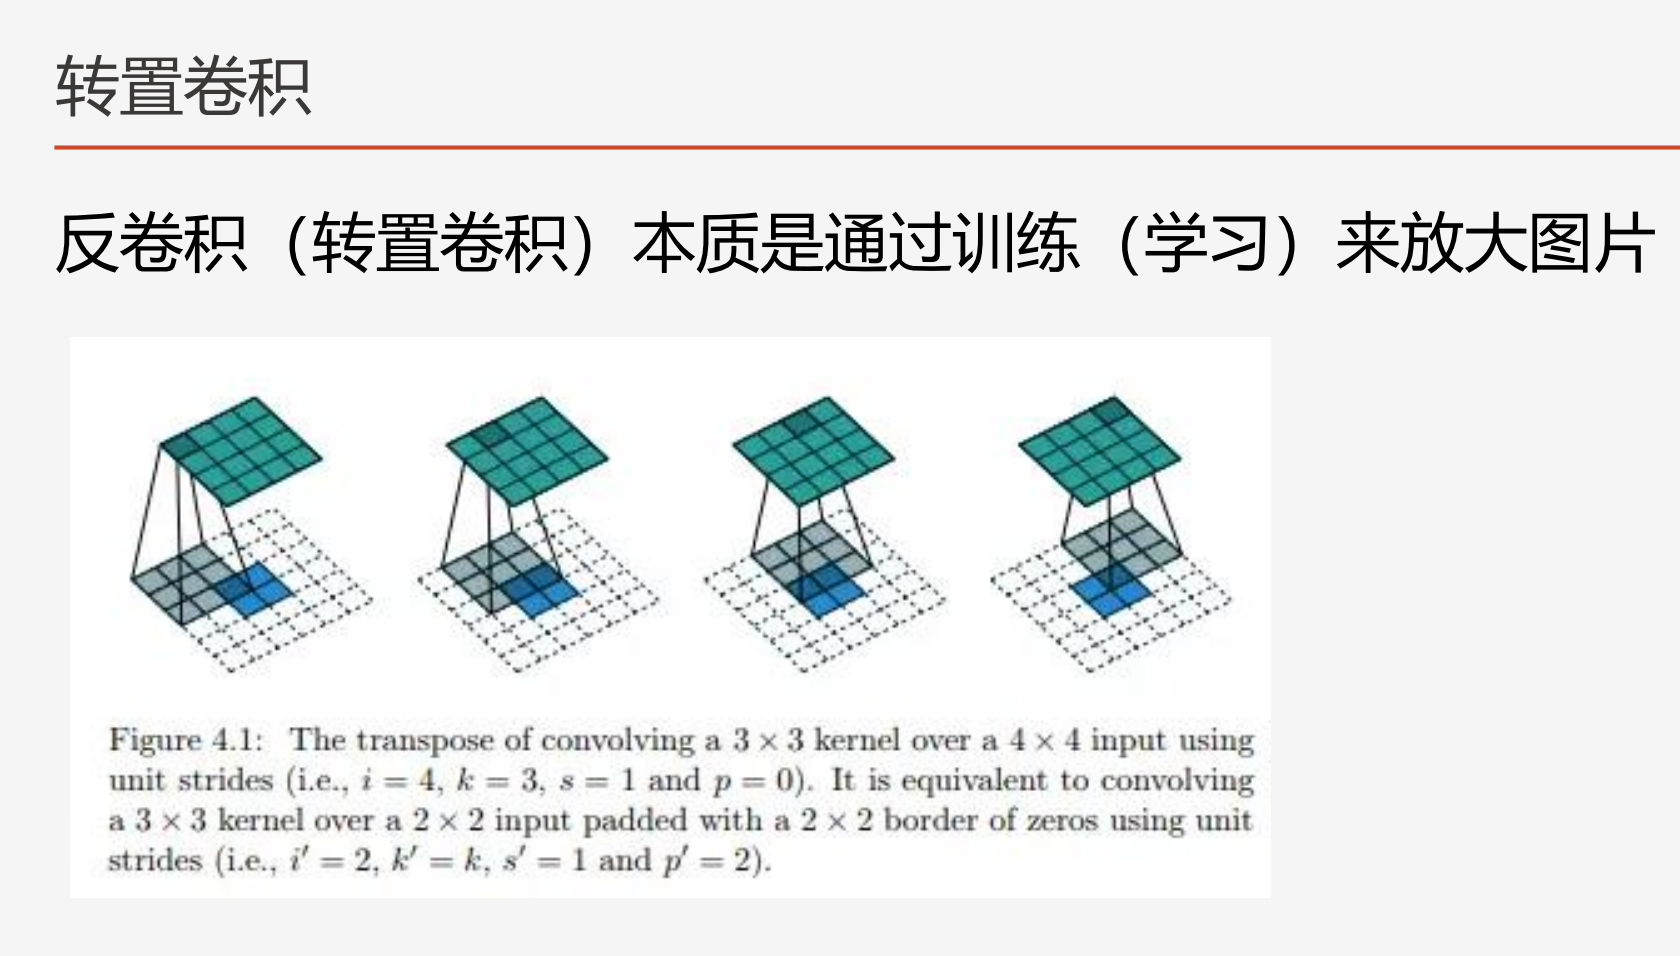
容易想到三种方式,分别对应最大池化、平均池化和卷积操 作的反过来使用。
- 插值法
- 反池化
- 反卷积(转置卷积)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
filters,
kernel_size,
strides=(1, 1),
padding='valid',
output_padding=None,
data_format=None,
dilation_rate=(1, 1),
activation=None,
use_bias=True,
kernel_initializer='glorot_uniform',
bias_initializer='zeros',
kernel_regularizer=None,
bias_regularizer=None,
activity_regularizer=None,
kernel_constraint=None,
bias_constraint=None,
**kwargs
)
Args filters整数,输出空间的维度(即卷积中输出滤波器的数量)。 kernel_size一个整数或2个整数的元组/列表,指定2D卷积窗口的高度和宽度。可以是一个整数,指定所有空间维度的相同值。 strides一个整数或2个整数的元组/列表,指定沿高度和宽度的卷积步幅。可以是单个整数,以为所有空间尺寸指定相同的值。指定任何跨步值!= 1与指定任何 dilation_rate值!= 1不兼容。padding"valid"或"same"之一(不区分大小写)。"valid"意味着没有填充。"same"导致在输入的左/右或上/下均匀填充零,以使输出具有与输入相同的高度/宽度尺寸。output_padding一个整数或2个整数的元组/列表,指定沿输出张量的高度和宽度的填充量。可以是单个整数,以为所有空间尺寸指定相同的值。沿给定尺寸的输出填充量必须小于沿相同尺寸的步幅。如果设置为“ None(默认),则将推断输出形状。data_format字符串, channels_last(默认)或channels_first中的一个。输入中尺寸的顺序。channels_last对应于形状为(batch_size, height, width, channels)输入,而channels_first对应于形状为(batch_size, channels, height, width)。它的默认值为在~/.keras/keras.json配置文件中找到的image_data_format值。如果您从未设置,那么它将是“ channels_last”。dilation_rate一个整数,指定扩张卷积的所有空间维度的扩张率。不支持为不同维度指定不同的膨胀率。目前,指定任何 dilation_rate值 != 1 与指定任何 stride 值 != 1 是不兼容的。activation要使用的激活功能。如果您未指定任何内容,则不会应用任何激活(请参阅 keras.activations)。use_biasBoolean,层是否使用偏置向量。 kernel_initializerkernel权重矩阵的初始化程序(请参阅keras.initializers)。默认为“glorot_uniform”。bias_initializer偏置向量的初始化程序(请参阅 keras.initializers)。默认为“零”。kernel_regularizer正则化函数应用于 kernel权重矩阵(请参阅keras.regularizers)。bias_regularizer将正则化函数应用于偏差向量(请参阅 keras.regularizers)。activity_regularizer正则化函数应用于图层的输出(其“激活”)(请参阅 keras.regularizers)。kernel_constraint约束函数应用于内核矩阵(请参阅 keras.constraints)。bias_constraint将约束函数应用于偏差向量(请参阅 keras.constraints)。
语义分割的跳级结构
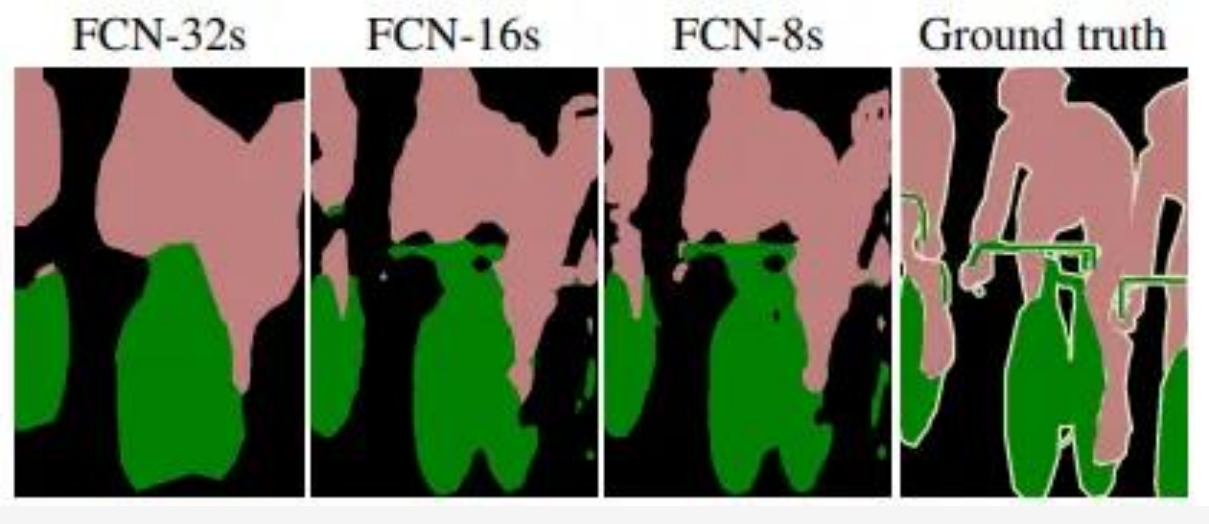
增加Skips结构将最后一层的预测(有更富的全局信息) 和更浅层(有更多的局部细节)的预测结合起来, 这样可以在遵守全局预测的同时进行局部预测。
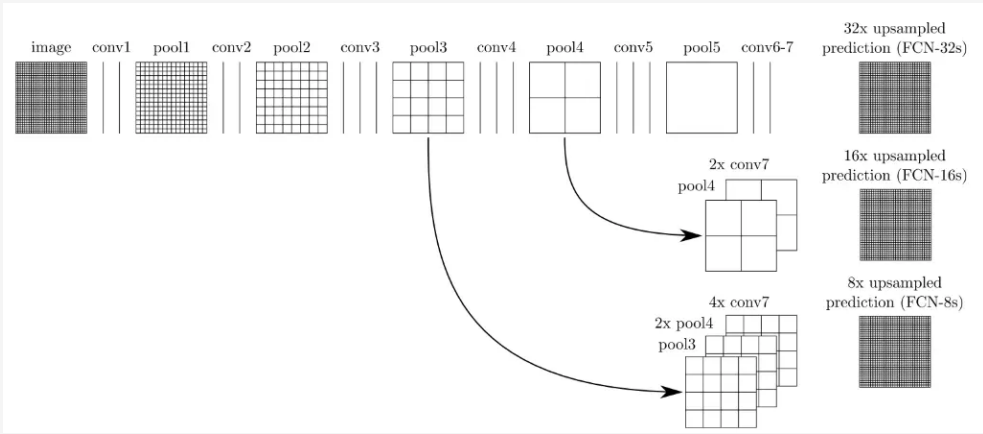
将底层(stride 32)的预测(FCN-32s)进行2倍的上采样 得到的图像,并与从pool4层(stride 16)进行的预测融合 起来(相加),这一部分的网络被称为FCN-16s。随后将这 一部分的预测再进行一次2倍的上采样并与从pool3层得到的 预测融合起来,这一部分的网络被称为FCN-8s。
全卷积神经网络(FCN)的缺点
- 得到的结果还不够精细,对细节不够敏感;
- 没有考虑像素与像素之间的关系,缺乏空间一致性等。
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 YuKiFuHaNeの博客!
相关推荐

2023-07-14
图像语义分割 FCN
import tensorflow as tf import matplotlib.pyplot as plt import numpy as np import os import glob 打印Tensorflow版本1print('Tensorflow version:{}'.format(tf.__version__)) 打印是否支持GPU加速1print(tf.test.is_gpu_available()) 获取图片路径1images = glob.glob('./images/*.jpg') 获取标注图片的路径1anno = glob.glob('./annotations/trimaps/*.png') 图片和标注图片做乱序1234np.random.seed(2023)index = np.random.permutation(len(images))images = np.array(images)[index]anno = np.array(anno)[index] ...

2023-07-14
DCGAN 生成动漫头像实战
import tensorflow as tf from tensorflow import keras from tensorflow.keras import layers import matplotlib.pyplot as plt %matplotlib inline import numpy as np import glob import os 查看tensorflow版本1tf.__version__ 查看是否支持GPU1tf.test.is_gpu_available() 获取图片路径1image_path = glob.glob('E:anime-face/Anime Faces/*') 定义加载函数1234567def load_image(image_path): img = tf.io.read_file(image_path) img = tf.image.decode_jpeg(img,channels=3)# img = tf.image.resize(img,[64,64]) img = tf...
2023-07-14
LinkNet 图像语义分割
import tensorflow as tf from tensorflow import keras import numpy as np import os %matplotlib inline import matplotlib.pyplot as plt import glob 查看Tensorflow版本1tf.__version__ 仅在需要时申请显存空间程序初始运行时消耗 很少的显存,随着程序的运行而动态申请显存;GPU 的显存使用策略设置为 “仅在需要时申请显存空间”) 123gpus = tf.config.list_physical_devices(device_type='GPU')for gpu in gpus: tf.config.experimental.set_memory_growth(device=gpu, enable=True) glob读取路径训练数据12img = glob.glob('E:images/leftImg8bit/train/*/*.png') # tf.io.glob...

2023-07-14
DCGAN 概念与设计要点
DCGAN的设计 取消所有pooling层。G网络中使用转置卷积( transposed convolutional layer)进行上采样,D网络中用 加入stride的卷积代替pooling。 去掉FC层,使网络变为全卷积网络 G网络中使用ReLU作为激活函数,最后一层使用tanh D网络中使用LeakyReLU作为激活函数 在generator和discriminator上都使用batchnorm。 解决初始化差的问题 帮助梯度传播到每一层 防止generator把所有的样本都收敛到同一个点。 直接将BN应用到所有层会导致样本震荡和模型不稳定,通过在 generator输出层和discriminator输入层不采用BN可以防止这种现象 使用Adam优化器, beta1(一阶矩估计的指数衰减率)的值设置为0.5 论文参数 LeakyReLU的斜率是0.2. learning rate=0.0002 batch size是128

2023-07-14
城市街景语义分割 UNET
import tensorflow as tf import numpy as np import os %matplotlib inline import matplotlib.pyplot as plt import glob 获取img、label路径12img = glob.glob('./images/leftImg8bit/train/*/*.png')#tf.io.glob.globlabel = glob.glob('./images/gtFine/train/*/*_gtFine_labelIds.png') 获取img_val、label_val路径12img_val = glob.glob('./images/leftImg8bit/val/*/*.png')label_val = glob.glob('./images/gtFine/val/*/*_gtFine_labelIds.png') 对训练路径进行乱序(减轻shuffle)123index = np.random...
2023-07-14
U-Net 模型概念
语义分割的UNET网络结构Unet是2015年诞生的模型,它几乎是当前segmentation项 目中应用最广的模型。 Unet能从更少的训练图像中进行学习。 当它在少于 40 张图 的生物医学数据集上训练时,IOU 值仍能达到 92%。 U-net网络非常简单,前半部分作用是特征提取,后半部分是上采样。 在一些文献中也把这样的结构叫做编码器-解码器结构。 由于此网络整体结构类似于大写的英文字母U,故得名U-net。 1234U-net与其他常见的分割网络有一点非常不同的地方:U-net采用了完全不同的特征融合方式:拼接(tf.concat)U-net采用将特征在channel维度拼接在一起,形成更厚的特征。而FCN融合时使用的对应点相加,并不形成更厚的特征。 语义分割网络在特征融合两种办法语义分割网络在特征融合时有两种办法: FCN式的对应点相加,对应于TensorFlow中的tf.add()函数; U-net式的channel维度拼接融合,对应于TensorFlow的 tf.concat()函数,比较占显存。 UNET网络结构特点1、网络对图像特征的多尺度特征...

