InfoGAN 核心概念解析
概念
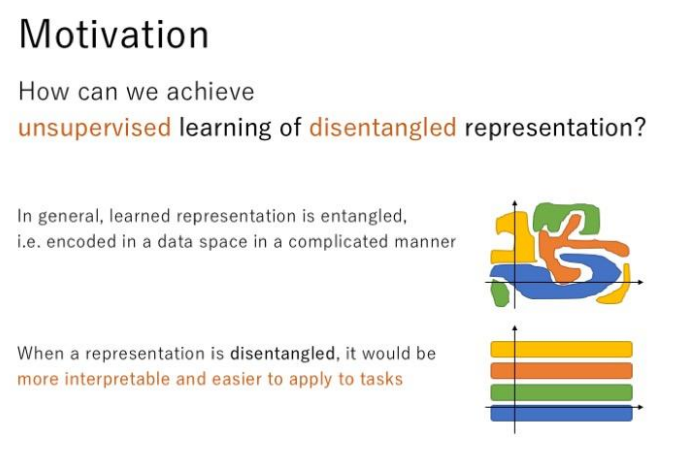
InfoGAN所要达到的目标就是通过非监督学习得到可分解 的特征表示。使用GAN加上最大化生成的图片和输入编码 之间的互信息。 最大的好处就是可以不需要监督学习,而且不需要大量额 外的计算花销就能得到可解释的特征
实现
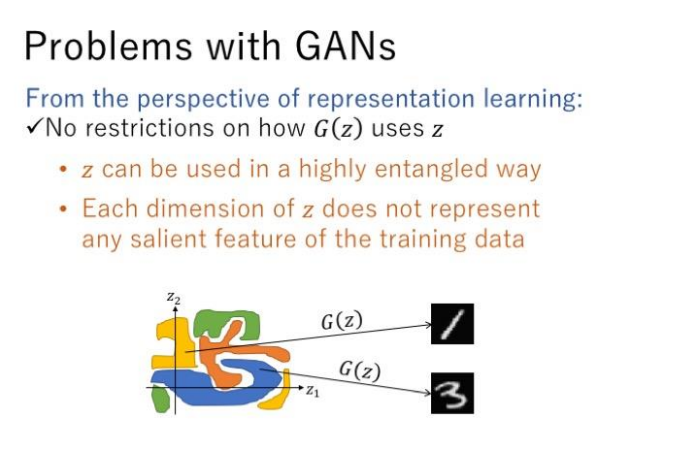
InfoGAN的出发点,它试图利用z,寻找一个可解释的表达, 于是它将z进行了拆解,一是噪声z,二是可解释的隐变量c, 而我们希望通过约束c与生成数据之间的关系,可以使得c里 面包含有对数据的可解释的信息。
如对MNIST数据,c可以分为categorical latent code代 来 表数字种类信息(0~9),以及continuous latent code来 表示倾斜度、笔画粗细等等
在生成器中除了原先的噪声z还增加了一个隐含编码c,所谓 InfoGAN,其中Info代表互信息,它表示生成数据x与隐藏编 码c之间关联程度的大小,为了使的x与c之间关联密切,所以 我们需要最大化互信息的值,据此对原始GAN模型的值函数 做了一点修改,相当于加了一个互信息的正则化项
互信息:我们可以把互信息看成当观测到y值而造成 的x的不确定性的减小。如果x,y是相互独立没有相关性,即 互信息的值为0,那么已知y值的情况下推测x与x的原始分布 没有区别;如果x,y有相关性,即互信息的值大于0,那么已 知y值的情况下,我们就能知道哪些x的值出现的概率更大
==通过使用连续的和离散的隐含因子来学习可分解的特征==
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 YuKiFuHaNeの博客!
相关推荐

2023-07-14
DCGAN 概念与设计要点
DCGAN的设计 取消所有pooling层。G网络中使用转置卷积( transposed convolutional layer)进行上采样,D网络中用 加入stride的卷积代替pooling。 去掉FC层,使网络变为全卷积网络 G网络中使用ReLU作为激活函数,最后一层使用tanh D网络中使用LeakyReLU作为激活函数 在generator和discriminator上都使用batchnorm。 解决初始化差的问题 帮助梯度传播到每一层 防止generator把所有的样本都收敛到同一个点。 直接将BN应用到所有层会导致样本震荡和模型不稳定,通过在 generator输出层和discriminator输入层不采用BN可以防止这种现象 使用Adam优化器, beta1(一阶矩估计的指数衰减率)的值设置为0.5 论文参数 LeakyReLU的斜率是0.2. learning rate=0.0002 batch size是128

2023-07-14
DCGAN 实战:MNIST 手写数字生成
import tensorflow as tf from tensorflow import keras from tensorflow.keras import layers import matplotlib.pyplot as plt %matplotlib inline import numpy as np import glob import os 查看tensorflow版本1tf.__version__ 查看是否支持GPU1tf.test.is_gpu_available() 加载mnist手写数据集1(train_image,train_labels),(_,_) = tf.keras.datasets.mnist.load_data() 查看数据12train_image.shape(60000, 28, 28) 12train_image.dtypedtype('uint8') 数据转换1train_image = train_image.reshape(train_image.shape[0],28,28,1).astype(...

2023-07-14
GAN
GAN的设计 生成器的损失由判别器输出来计算的,而判别器输出的是一个概率值,可以通过交叉熵计算 什么是GAN生成式对抗网络(GAN, Generative Adversarial Networks )是一种深度学习模型,是近年来复杂分 布上无监督学习最具前景的方法之一 机器学习的模型可大体分为两类,生成模型( Generative Model)和判别模型(Discriminative Model)。判别模型需要输入变量 ,通过某种模型来 预测 。生成模型是给定某种隐含信息,来随机产生观 测数据 GAN原理GAN 主要包括了两个部分,即生成器 generator 与 判别器 discriminator。==生成器主要用来学习真实图像 分布从而让自身生成的图像更加真实,以骗过判别器 。判别器则需要对接收的图片进行真假判别。== 在训练过程中,生成器努力地让生成的图像更加真实 ,而判别器则努力地去识别出图像的真假,这个过程 相当于一个二人博弈,随着时间的推移,生成器和判 别器在不断地进行对抗。 最终两个网络达到了一个动态均衡:生成器生成...

2023-07-14
CycleGAN 概述
Cycle GAN解决了模型需要成对数据进行训练的困难 CycleGAN的原理可以概述为:将一类图片转换成另一类图片。也就是说,现在有两个样本空间,x和Y,我们希望把x空间中的样本转换成Y空间中的样本。(获取一个数据集的特征,并转化成另一个数据集的特征) 单独对抗损失Loss不能保证学习函数可以将单个输入Xi映射到期望输出Yi 在足够大的样本容量下,网络可以将相同的输入图像集合映射到目标域中图像的任何随机排列,其中任亻可学习的映射可以归纳出与目标分布匹配的输出分布(即:映射F完全可以将所有×都映射为Y空间中的同一张图片,使损失无效化)。 循环一致性损失(cycle consistency loss) 将X的图片转换到Y空间后,应该还可以转换回来。这样就杜绝模型把所有X的图片都转换为Y空间中的同一张图片了 判别器Loss 生成器Loss 一个单向GAN有两个loss,而CycleGAN加起来总共有四个loss 局限性==对颜色、纹理等的转换效果比较好,对多样性高的、多变的转换效果不好(如几何转换)==
2023-07-14
CGAN(Conditional GAN)
CGAN(condaitional)原始GAN缺点生成的图像是随机的,不可预测的,无法控制网络输出特定的图片,生成目标不明确,可控性不强针对原始GAN不能生成具有特定属性的图片的问题,MehdiMirza等人提出了cGAN,其核心在于将属性信息y融入生成器G和判别器D中,属性y可以是任何标签信息,例如图像的类别、人脸图像的面部表情等。 CGANcGAN的中心思想是希望可以控制GAN生成的图片,而不是单纯的随机生成图片。具体来说,ConditionalGAN在生成器和判别器的输入中增加了额外的条件信息,生成器生成的图片只有足够真实且与条件相符,才能够通过判别器。 cGAN将无监督学习转为有监督学习使得网络可以更好地在我们的掌控下进行学习!比如,我们输入条件狗生成一张狗的图片输入条件猫生成一张猫的图片 CGAN模型架构(与传统GAN添加判别输入)

2023-07-14
ACGAN 网络结构
ACGAN结构 生成器 判别器 损失

