from tensorflow import keras from tensorflow.keras import layers import pandas as pd import numpy as np import matplotlib.pyplot as plt %matplotlib inlineimport datetime
pandas读取csv文件 1 data = pd.read_csv('./PRSA_data_2010.1.1-2014.12.31.csv')
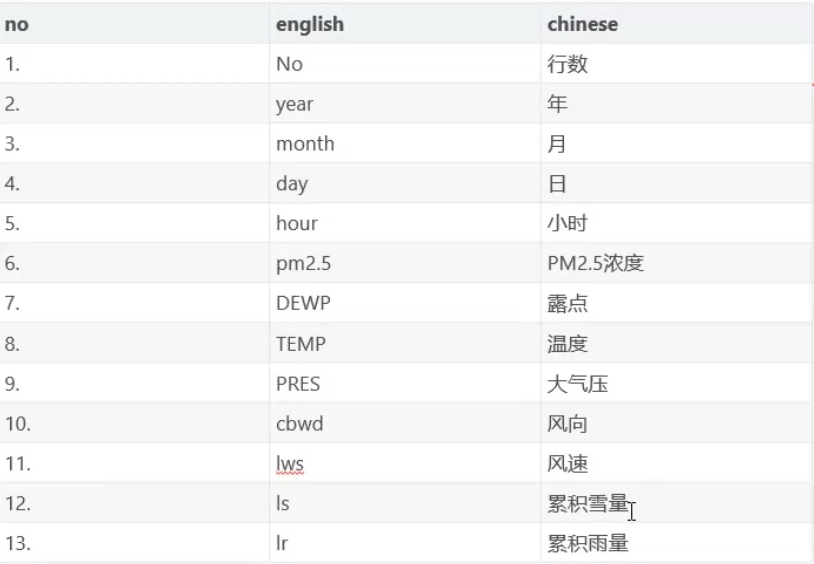
No
year
month
day
hour
pm2.5
DEWP
TEMP
PRES
cbwd
Iws
Is
Ir
0
1
2010
1
1
0
NaN
-21
-11.0
1021.0
NW
1.79
0
0
1
2
2010
1
1
1
NaN
-21
-12.0
1020.0
NW
4.92
0
0
2
3
2010
1
1
2
NaN
-21
-11.0
1019.0
NW
6.71
0
0
3
4
2010
1
1
3
NaN
-21
-14.0
1019.0
NW
9.84
0
0
4
5
2010
1
1
4
NaN
-20
-12.0
1018.0
NW
12.97
0
0
查看每列的数据类型(.info()) 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 <class 'pandas.core.frame.DataFrame'> RangeIndex: 43824 entries, 0 to 43823 Data columns (total 13 columns): # Column Non-Null Count Dtype --- ------ -------------- ----- 0 No 43824 non-null int64 1 year 43824 non-null int64 2 month 43824 non-null int64 3 day 43824 non-null int64 4 hour 43824 non-null int64 5 pm2.5 41757 non-null float64 6 DEWP 43824 non-null int64 7 TEMP 43824 non-null float64 8 PRES 43824 non-null float64 9 cbwd 43824 non-null object 10 Iws 43824 non-null float64 11 Is 43824 non-null int64 12 Ir 43824 non-null int64 dtypes: float64(4), int64(8), object(1) memory usage: 4.3+ MB
获取每列的标头 1 2 3 Index(['No', 'year', 'month', 'day', 'hour', 'pm2.5', 'DEWP', 'TEMP', 'PRES', 'cbwd', 'Iws', 'Is', 'Ir'], dtype='object')
查看pm2.5的NaN值个数(没有数据) 1 data['pm2.5'].isna().sum()#isna() 为NA值
使用向前填充方法,填充NaN值(.fillna(method='ffill')) 1 data = data.iloc[24:].fillna(method='ffill')#前向填充
将时间由多列合并成一列 1 2 3 4 5 6 data['tm'] = data.apply(lambda x:datetime.datetime(year=x['year'], month=x['month'], day=x['day'], hour=x['hour']), axis=1 )
删除年、月、日、小时列,保留新合成的tm列 1 data.drop(columns=['year','month','day','hour','No'],inplace=True)
设置tm列为索引 1 data.set_index('tm',inplace=True)#设置索引
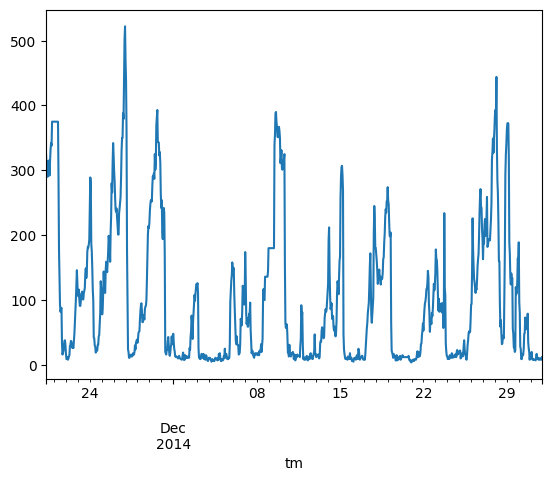
绘制pm2.5变化曲线 1 data['pm2.5'][-1000:].plot()
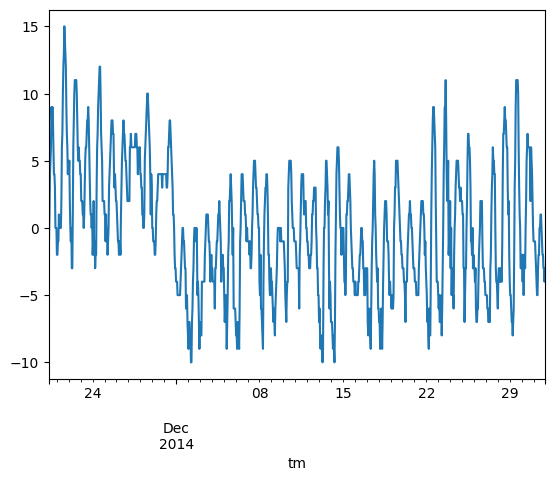
绘制TEMP变化曲线 1 data['TEMP'][-1000:].plot()
设定每次预测以多久的数据进行观察和预测多久的时间 1 2 seq_length = 5*24#定义观察前面多久的值 delay = 24 #预测时间
将数据进行分批(后面分批导入训练,达到每个批次多少小时数据预测多少小时的数据) 1 2 3 data_ = [] for i in range(len(data)-seq_length-delay): data_.append(data.iloc[i:i+seq_length+delay])
获取数据的值并转array 1 data_ = np.array([df.values for df in data_])
1 2 data_.shape (43656, 144, 11)
数据乱序 1 np.random.shuffle(data_)
数据分割 训练数据 预测的真实值 1 2 x.shape,y.shape ((43656, 120, 11), (43656,))
划分训练数据与测试数据 1 2 3 4 5 6 split_b = int(data_.shape[0]*0.8) train_x = x[:split_b] train_y = y[:split_b] test_x = x[split_b:] test_y = y[split_b:]
计算mean(均值)与std(方差),一定要训练集的 1 2 mean = train_x.mean(axis=0)#计算每一列的均值 std = train_x.std(axis=0)#计算方差
保存mean(均值)与std(方差) 1 2 np.save(file='mean.npy',arr=mean) np.save(file='std.npy',arr=std)
如果是1维或2维数组,可以使用np.savetxt(), 如:
import numpy as np
创建数组(2维) a = np.arange(100).reshape((20, 5))
写入文件 np.savetxt(fname=”data.csv”, X=a, fmt=”%d”,delimiter=”,”)
读取文件 b = np.loadtxt(fname=”data.csv”, dtype=np.int, delimiter=”,”)
如果是高维数组,可以使用np.save(),如:
import numpy as np
创建数组(3维) a = np.arange(100).reshape((10, 5, 2))
存储 np.save(file=”data.npy”, arr=a)
读取 b= np.load(file=”data.npy”)
数据标注化(数据标准化目的:让不同特征数据处于同一取值范围 有利于神经网络的训练(反向传播)、将来对数据的预测 标准化减均值除方差) 1 2 train_x = (train_x - mean)/std#标准化减均值除方差 test_x = (test_x - mean)/std#标准化减均值除方差
设置BATCH_SIZE Flatten模型 构建模型 1 2 3 4 model = keras.Sequential() model.add(layers.Flatten(input_shape=(train_x.shape[1:]))) model.add(layers.Dense(32,activation='relu')) model.add(layers.Dense(1))
模型配置 1 2 3 4 model.compile(optimizer='adam', loss='mse',#回归问题均方差 metrics=['mae']#度量平均绝对误差 )
模型训练 1 2 3 4 5 history = model.fit(train_x,train_y, batch_size=BATCH_SIZE, epochs=50, validation_data=(test_x,test_y) )
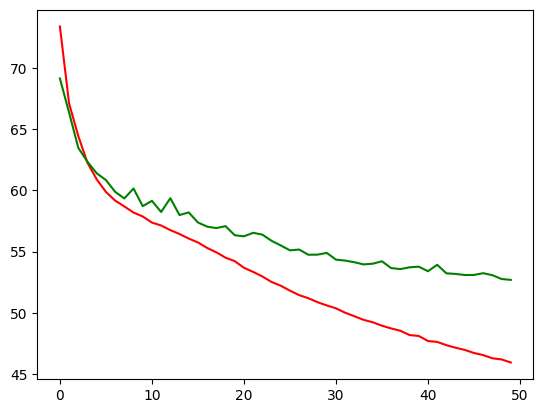
模型训练mae数据绘制 1 2 plt.plot(history.epoch,history.history['mae'],c='r') plt.plot(history.epoch,history.history['val_mae'],c='g')
LSTM网络模型 (LSTM网络 循环神经网络 擅长预测变化趋势) 构建模型 1 2 3 model = keras.Sequential() model.add(layers.LSTM(32,input_shape=(120,11))) model.add(layers.Dense(1))
模型配置 1 2 3 4 model.compile(optimizer='adam', loss='mse',#回归问题均方差 metrics=['mae']#度量平均绝对误差 )
模型训练 1 2 3 4 5 history = model.fit(train_x,train_y, batch_size=BATCH_SIZE, epochs=150, validation_data=(test_x,test_y) )
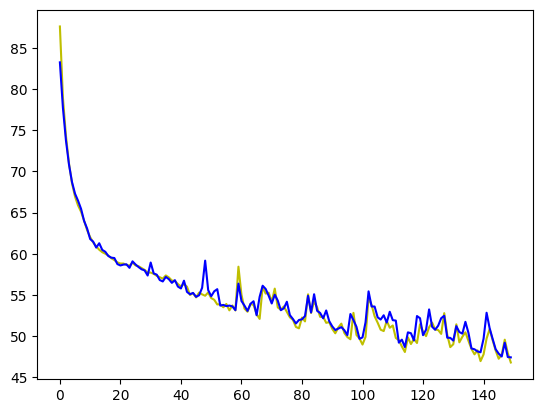
模型训练mae数据绘制
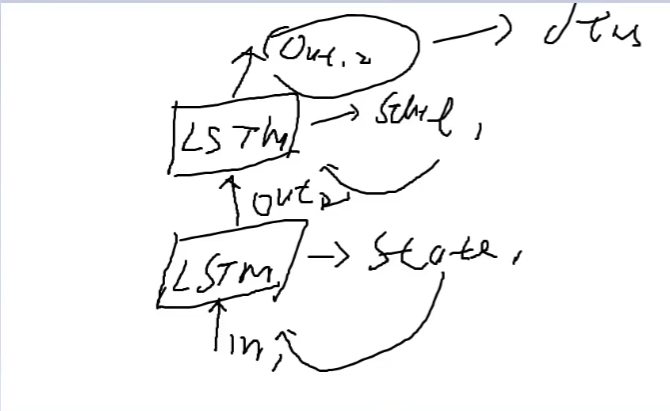
LSTM层的优化 多层LSTM网络 构建模型 1 2 3 4 5 6 model = keras.Sequential() model.add(layers.LSTM(32,input_shape=(120,11),return_sequences=True))#序列中每一次预测都做输出 model.add(layers.LSTM(32,return_sequences=True))#序列中每一次预测都做输出 model.add(layers.LSTM(32,return_sequences=True))#序列中每一次预测都做输出 model.add(layers.LSTM(32)) model.add(layers.Dense(1))
如果设置return_sequences = True,该LSTM层会返回每一个time step的h,那么该层返回的就是1个由多个h组成的2维数组了,如果下一层不是可以接收2维数组的层,就会报错。所以一般LSTM层后面接LSTM层的话,设置return_sequences = True,如果接全连接层的话,设置return_sequences = False。
模型配置 1 2 3 4 model.compile(optimizer='adam', loss='mse',#回归问题均方差 metrics=['mae']#度量平均绝对误差 )
模型训练 1 2 3 4 5 history = model.fit(train_x,train_y, batch_size=BATCH_SIZE, epochs=150, validation_data=(test_x,test_y) )
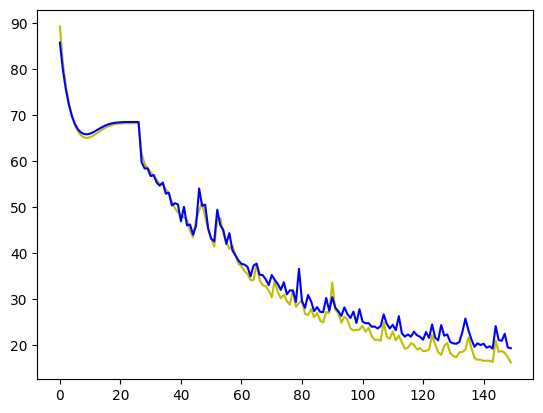
模型训练mae数据绘制 1 2 lt.plot(history.epoch,history.history['mae'],c='y') plt.plot(history.epoch,history.history['val_mae'],c='b')
STM层的优化 (LSTM层的优化和在训练中降低学习速率) 构建模型 1 2 3 4 5 6 model = keras.Sequential() model.add(layers.LSTM(32,input_shape=(120,11),return_sequences=True))#序列中每一次预测都做输出 model.add(layers.LSTM(32,return_sequences=True))#序列中每一次预测都做输出 model.add(layers.LSTM(32,return_sequences=True))#序列中每一次预测都做输出 model.add(layers.LSTM(32)) model.add(layers.Dense(1))
设置回调函数来控制学习速率1 2 lr_reduce = keras.callbacks.ReduceLROnPlateau('val_loss',patience=3,factor=0.5, min_lr=0.000001)#val_loss在3个epochs内学习降低学习速率为0.5 ,min_lr设置最小学习速率
模型配置 1 2 3 4 model.compile(optimizer='adam', loss='mse',#回归问题均方差 metrics=['mae']#度量平均绝对误差 )
模型训练 1 2 3 4 5 6 history = model.fit(train_x,train_y, batch_size=BATCH_SIZE, epochs=200, validation_data=(test_x,test_y), callbacks=[lr_reduce] )
模型保存 1 model.save('pm2.5_v3.h5')
评价模型1 model.evaluate(test_x,test_y,verbose=)#评价模型 verbose控制是否显示进度条默认1:显示 0:不显示
1 2 273/273 [==============================] - 4s 13ms/step - loss: 3044.0330 - mae: 34.1014 [3044.032958984375, 34.101444244384766]
模型预测 读取保存的mean(train数据的均值)和std(train数据的标准差 ) 1 2 3 #读取保存的mean(train数据的均值)和std(train数据的标准差 ) mean = np.load(file='mean.npy') std = np.load(file='std.npy')
测试数据标注化 1 data_test = (data_test-mean)/std
转换为array格式 1 data_test = data_test.to_numpy()
维度增加 1 data_test = np.expand_dims(data_test,axis=0)
预测 1 model.predict(data_test)