1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
| import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import LabelEncoder, StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
# 检查是否有可用的 CUDA 设备
device = 'cuda' if torch.cuda.is_available() else 'cpu'
# 生成示例数据
data = pd.DataFrame(pd.read_excel("./数据集.xlsx")) # 请替换为你的实际数据文件路径
# 选择输入特征和输出
features = ["雾滴粒径µm","RSF"]#"农药", "助剂","表面张力", "粘度",, "铺展系数", "雾滴粒径µm",
outputs = ["飘移损失", "飘移距离"]
# # 处理中文特征
# label_encoders = {}
# for feature in ["农药", "助剂"]:
# label_encoder = LabelEncoder()
# data[feature] = label_encoder.fit_transform(data[feature])
# label_encoders[feature] = label_encoder
# 标准化数值特征
scaler = StandardScaler()
data[features] = scaler.fit_transform(data[features])
X = np.array(data[features])
y = np.array(data[outputs])
# 划分数据集为训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# X_train, X_test, y_train, y_test = X,X,y,y
# 转换为 PyTorch 的 Tensor,并移动到 GPU
X_train_tensor = torch.FloatTensor(X_train).to(device)
y_train_tensor = torch.FloatTensor(y_train).to(device)
X_test_tensor = torch.FloatTensor(X_test).to(device)
y_test_tensor = torch.FloatTensor(y_test).to(device)
# 定义一个大型神经网络模型
class LargeModel(nn.Module):
def __init__(self, input_size, hidden_size1, hidden_size2, output_size):
super(LargeModel, self).__init__()
self.fc1 = nn.Linear(input_size, hidden_size1)
self.relu1 = nn.ReLU()
self.fc2 = nn.Linear(hidden_size1, hidden_size2)
self.relu2 = nn.ReLU()
self.fc3 = nn.Linear(hidden_size2, output_size)
def forward(self, x):
x = self.fc1(x)
x = self.relu1(x)
x = self.fc2(x)
x = self.relu2(x)
x = self.fc3(x)
return x
# 初始化大型神经网络模型
input_size = len(features) # 输入特征的维度
hidden_size1 = 256 # 第一个隐藏层的大小
hidden_size2 = 128 # 第二个隐藏层的大小
output_size = len(outputs) # 输出的维度
model = LargeModel(input_size, hidden_size1, hidden_size2, output_size).to(device)
criterion = nn.MSELoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)
# 记录训练过程中的损失
train_losses = []
test_losses = []
# 将数据转为 DataLoader
train_dataset = TensorDataset(X_train_tensor, y_train_tensor)
train_loader = DataLoader(train_dataset, batch_size=16, shuffle=True)
# 训练神经网络模型
num_epochs = 70
for epoch in range(num_epochs):
model.train()
for inputs, targets in train_loader:
optimizer.zero_grad()
outputs = model(inputs)
loss = criterion(outputs, targets)
loss.backward()
optimizer.step()
train_losses.append(loss.item())
# 在测试集上评估模型
model.eval()
with torch.no_grad():
y_pred = model(X_test_tensor)
test_loss = criterion(y_pred, y_test_tensor)
test_losses.append(test_loss.item())
if (epoch + 1) % 10 == 0:
print(f'Epoch [{epoch+1}/{num_epochs}], Loss: {loss.item():.4f}, Test Loss: {test_loss.item():.4f}')
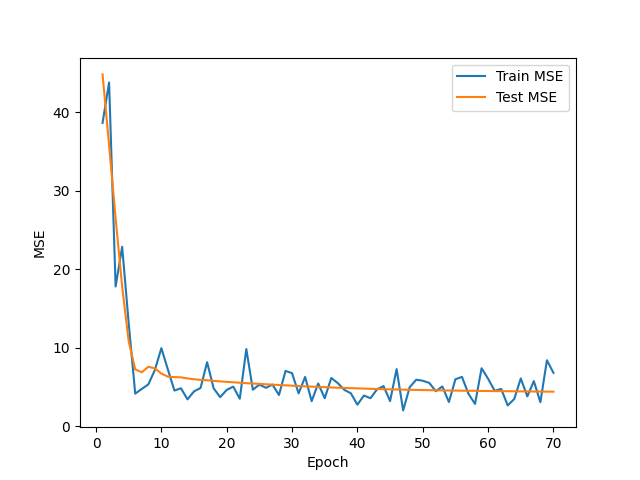
# 绘制MSE曲线
plt.plot(range(1, num_epochs+1), train_losses, label='Train MSE')
plt.plot(range(1, num_epochs+1), test_losses, label='Test MSE')
plt.xlabel('Epoch')
plt.ylabel('MSE')
plt.legend()
plt.show()
# 在测试集上评估模型并绘制真实值和预测值的散点图
model.eval()
with torch.no_grad():
y_pred = model(X_test_tensor)
# 转换为 NumPy 数组
X_test_np = X_test_tensor.cpu().numpy()
y_test_np = y_test_tensor.cpu().numpy()
y_pred_np = y_pred.cpu().numpy()
X_test_np = scaler.inverse_transform(X_test_np)
# # 绘制真实值和预测值的散点图
# plt.scatter(X_test, y_test, label='True Values')
# plt.scatter(X_test, y_pred.numpy(), label='Predicted Values', marker='o', color='r')
# plt.rcParams['font.sans-serif'] = ['SimHei']
# plt.rcParams['axes.unicode_minux'] = False
# plt.rc('font', family='Microsoft JhengHei') # 处理绘图中文乱码显示
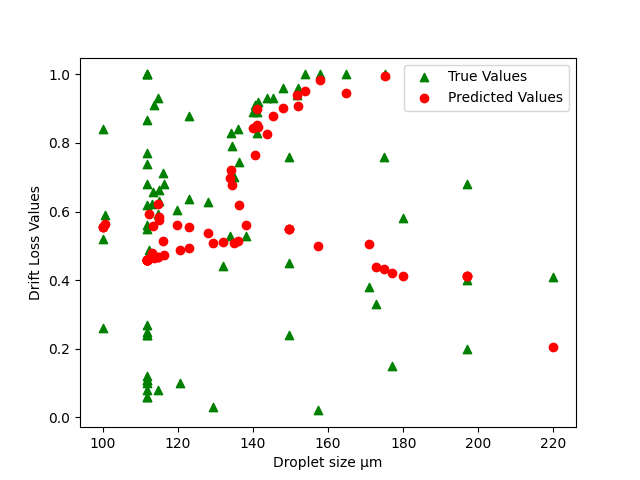
# 雾滴粒径µm->飘移损失预测
plt.scatter(X_test_np[:, 0], y_test_np[:, 0], label='True Values', marker='^', color='g')
plt.scatter(X_test_np[:, 0], y_pred_np[:, 0], label='Predicted Values', marker='o', color='r')
plt.xlabel('Droplet size µm')
plt.ylabel('Drift Loss Values')
plt.legend()
plt.show()
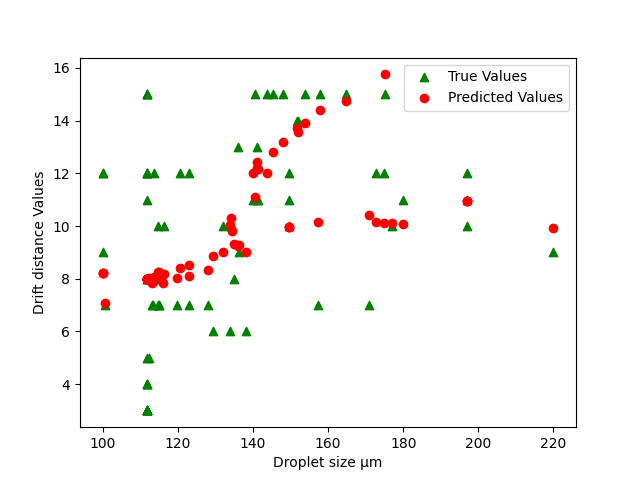
# 雾滴粒径µm->飘移距离预测
plt.scatter(X_test_np[:, 0], y_test_np[:, 1], label='True Values', marker='^', color='g')
plt.scatter(X_test_np[:, 0], y_pred_np[:, 1], label='Predicted Values', marker='o', color='r')
plt.xlabel('Droplet size µm')
plt.ylabel('Drift distance Values')
plt.legend()
plt.show()
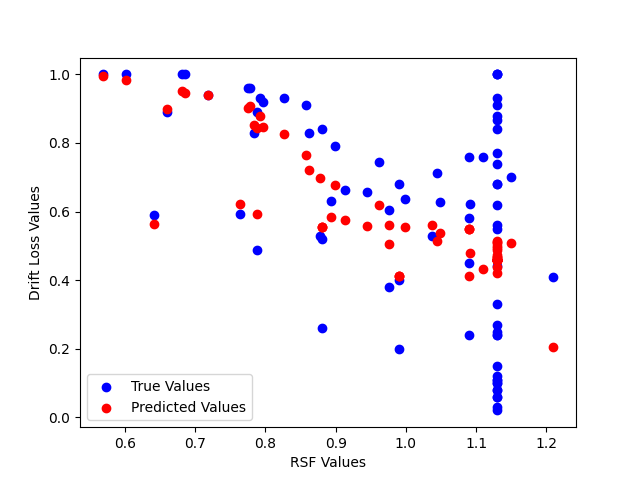
#RSF->飘移损失预测
plt.scatter(X_test_np[:, 1], y_test_np[:, 0], label='True Values', color='blue')
plt.scatter(X_test_np[:, 1], y_pred_np[:, 0], label='Predicted Values', color='red')
plt.xlabel('RSF Values')
plt.ylabel('Drift Loss Values')
plt.legend()
plt.show()
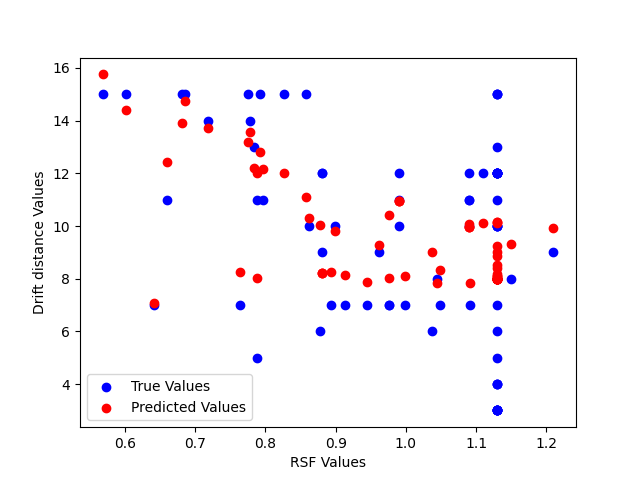
#RSF->飘移距离预测
plt.scatter(X_test_np[:, 1], y_test_np[:, 1], label='True Values', color='blue')
plt.scatter(X_test_np[:, 1], y_pred_np[:, 1], label='Predicted Values', color='red')
plt.xlabel('RSF Values')
plt.ylabel('Drift distance Values')
plt.legend()
plt.show()
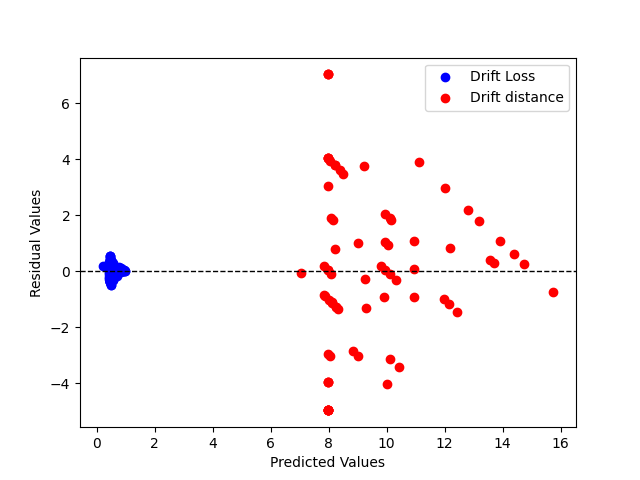
# 计算残差
residuals = y_test_np - y_pred_np
# 绘制残差图
plt.scatter(y_pred_np[:, 0], residuals[:, 0], label='Drift Loss', color='blue')
plt.scatter(y_pred_np[:, 1], residuals[:, 1], label='Drift distance', color='red')
plt.axhline(y=0, color='black', linestyle='--', linewidth=1) # 添加水平参考线
plt.xlabel('Predicted Values')
plt.ylabel('Residual Values')
plt.legend()
plt.show()
|