import tensorflow as tf from tensorflow import keras import matplotlib.pyplot as plt %matplotlib inline import numpy as np import glob import os

打印Tensorflow版本

1
print('Tensorflow version:{}'.format(tf.__version__))

打印是否能使用GPU加速运行

1
print(tf.test.is_gpu_available())

读取train、test数据集图片路径

1
2
train_image_path = glob.glob('./dc_2000/train/*.jpg')
test_image_path = glob.glob('./dc_2000/test/*.jpg')

将路径的图片名称提取出来

1
2
train_image_label = [label.split('\\')[1].split('.')[0] for label in train_image_path]
test_image_label = [label.split('\\')[1].split('.')[0] for label in test_image_path]

图片label有哪些

1
label_names = np.unique(train_image_label)#返回单个不重复元素的列表

标签与下标之间的转换

  • Label to Index

1
label_to_index = dict((name,i) for i,name in enumerate(label_names)) 
  • Index to Label

1
index_to_label = dict((i,name) for name,i in label_to_index.items())

train_label和test_label转index

1
2
3
#cat -> 0 ,dog -> 1
train_image_label = [label_to_index.get(name) for name in train_image_label]
test_image_label = [label_to_index.get(name) for name in test_image_label]

train图片的加载函数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
def load_preprosess_image(path,label):
image = tf.io.read_file(path)#读取
image = tf.image.decode_jpeg(image,channels=3)#channel默认0,因为是彩色图像有RGB三个通道
image = tf.image.resize(image,[300,300])#resize
#数据增强
image = tf.image.random_crop(image,[256,256,3])#随机位置裁剪出(256X256)大小图片,要通道数别忘了
image = tf.image.random_flip_left_right(image)#随机左右翻转
image = tf.image.random_flip_up_down(image)#随机上下翻转
# image = tf.image.random_brightness(image,0.5)#参数(图片,随机亮度范围非负数),0.5=50%
# image = tf.image.random_contrast(image,0,1)#随机对比度
# image = tf.image.random_hue(image,max_delta=0.3)#随机调整RGB图像的色调
# image = tf.image.random_saturation(image,lower=0.2,upper=1.8)#随机调整RGB图像的饱和度.

image = tf.cast(image,tf.float32)#改变数据类型
image = image /255#归一化
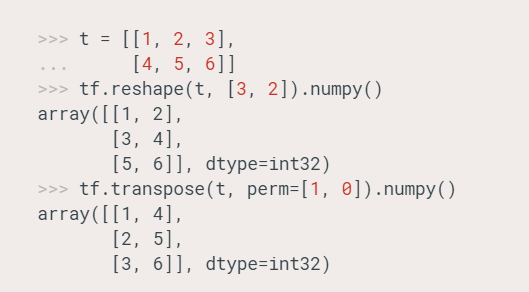
label = tf.reshape(label,[1])#变化维度 [1,2,3] -> [[1],[2],[3]]
return image,label

随机裁剪图片

1
tf.image.random_crop(image,[256,256,3])#随机位置裁剪出(256X256)大小图片,要RGB通道数别忘了

随机左右翻转

1
tf.image.random_flip_left_right(image)#随机左右翻转

随机上下翻转

1
tf.image.random_flip_up_down(image)#随机上下翻转

随机调整图像的亮度

1
tf.image.random_brightness(image,0.5)#参数(图片,随机亮度范围非负数),0.5=50%

通过随机因子调整图像的亮度,相当于adjust_brightness()使用在间隔[-max_delta, max_delta)中随机选取的delta.
参数:
image: 一个图像.
max_delta:float,必须是非负的.
seed:一个Python整数.用于创建一个随机种子.查看tf.set_random_seed行为

随机调整图像的对比度

1
tf.image.random_contrast(image,0,1)#随机对比度

通过随机因子调整图像的对比度,相当于adjust_contrast(),但使用了在区间[lower, upper]中随机选取的contrast_factor.
参数:
image:具有3个或更多维度的图像张量.
lower:浮点型,随机对比因子的下限.
upper:浮点型,随机对比因子的上限.
seed:一个Python整数,用于创建一个随机种子.查看tf.set_random_seed行为

随机调整RGB图像的色调

1
tf.image.random_hue(image,max_delta=0.3)#随机调整RGB图像的色调

用随机因子调整RGB图像的色调,相当于adjust_hue(),但是在区间[-max_delta, max_delta]使用delta随机选取的.
max_delta必须在间隔[0, 0.5]中.
参数:
image:RGB图像,最后维度的大小必须为3.
max_delta:浮点型,随机增量的最大值.
seed:特定于操作的seed,它将与图层seed一起使用,以确定将在此操作中使用的实际seed

随机调整RGB图像的饱和度

1
tf.image.random_saturation(image,lower=0.2,upper=1.8)#随机调整RGB图像的饱和度

用随机因子调整RGB图像的饱和度,相当于adjust_saturation(),但是在区间[lower, upper]中使用saturation_factor随机选取.
参数:
image:RGB图像,最后维度的大小必须为3.
lower:浮点型,随机饱和因子的下界.
upper:浮点型,随机饱和因子的上界.
seed:特定于操作的seed,它将与图层seed一起使用,以确定将在此操作中使用的实际seed

W3Cschool公式网站

test图片加载函数

1
2
3
4
5
6
7
8
def load_preprosess_test_image(path,label):
image = tf.io.read_file(path)#读取
image = tf.image.decode_jpeg(image,channels=3)#channel默认0,因为是彩色图像有RGB三个通道
image = tf.image.resize(image,[256,256])#resize
image = tf.cast(image,tf.float32)#改变数据类型
image = image /255#归一化
label = tf.reshape(label,[1])#变化维度 [1,2,3] -> [[1],[2],[3]]
return image,label

tf.image.convert_image_dtype使用注意:

tf.image.convert_image_dtype#转换数据类型时,如果原数据不是float类型时会自动做归一化处理,是float类型则不会做归一化

tf.reshape

关于tf.reshape函数我们需要知道的是:

函数用于张量维度调整,但是不会修改内部元素的数量以及相对顺序 shape中-1表示这个维度的大小,程序运行时会自动计算填充(因为变换前后元素数量不变,我们可以根据其他维度的大小,最终确定-1这个位置应该表示的数字) 如果需要通过修改内部元素的存储顺序以实现维度调整,需要使用tf.transpose函数 -1,就是缺省值,就是先以你们合适,到时总数除以你们几个的乘积,我该是几就是几。

设置AUTOTUNE

1
AUTOTUNE = tf.data.experimental.AUTOTUNE#AUTOTUNE根据CPU的个数自动使用进行运算

设置train_Dataset

1
2
train_image_ds = tf.data.Dataset.from_tensor_slices((train_image_path,train_image_label))#train图片路径与对应label
train_image_ds = train_image_ds.map(load_preprosess_image,num_parallel_calls=AUTOTUNE)#num_parallel_calls是cpu个数,默认None,传入AUTOTUNE可以最大限度发挥速度(并行运算)

设置test_Dataset

1
2
test_image_ds = tf.data.Dataset.from_tensor_slices((test_image_path,test_image_label))#test图片路径与对应label
test_image_ds = test_image_ds.map(load_preprosess_test_image,num_parallel_calls=AUTOTUNE)#num_parallel_calls是cpu个数,默认None,传入AUTOTUNE可以最大限度发挥速度(并行运算)

定义BATCH_SIZE大小

1
2
# 设置BATCH
BATCH_SIZE = 8

对train_Dataset数据进行乱序、定义批次和加速运行

1
2
train_image_ds = train_image_ds.shuffle(train_count).batch(BATCH_SIZE)#buffer_size 多大范围进行乱序
train_image_ds = train_image_ds.prefetch(AUTOTUNE)#在后台,一部分数据进行训练过程中读取另外一部分数据,能加速训练过程,prefetch(buffer_size) 让计算机自己计算

对test_Dataset数据定义批次和加速运行

1
2
test_image_ds = test_image_ds.batch(BATCH_SIZE)#buffer_size 多大范围进行乱序
test_image_ds = test_image_ds.prefetch(AUTOTUNE)#在后台,一部分数据进行训练过程中读取另外一部分数据,能加速训练过程,prefetch(buffer_size) 让计算机自己计算

==Datasetimgs,labels = next(iter(train_image_ds))#iter转换成生成器,next下一批次数据是iter可以进行迭代==

模型的搭建

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
model = keras.Sequential([
tf.keras.layers.Conv2D(64,(3,3),input_shape=(256,256,3),activation='relu'),#卷积层提取数据能力强,fit个数过小,有效信息没能穿过导致平静
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Conv2D(64,(3,3),activation='relu'),#卷积层提取数据能力强
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面
tf.keras.layers.MaxPooling2D(),#图像缩小一倍

tf.keras.layers.Conv2D(128,(3,3),activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Conv2D(128,(3,3),activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面
tf.keras.layers.MaxPooling2D(),#图像缩小一倍

tf.keras.layers.Conv2D(256,(3,3),activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Conv2D(256,(3,3),activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Conv2D(256,(1,1),activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面
tf.keras.layers.MaxPooling2D(),#图像缩小一倍

tf.keras.layers.Conv2D(512,(3,3),activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Conv2D(512,(3,3),activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Conv2D(512,(1,1),activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面
tf.keras.layers.MaxPooling2D(),#图像缩小一倍

tf.keras.layers.GlobalAveragePooling2D(),
tf.keras.layers.Dense(4096,activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Dense(4096,activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Dense(1000,activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Dense(512,activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Dense(126,activation='relu'),
tf.keras.layers.BatchNormalization(),#批标准化,放在每一层卷积层的后面

tf.keras.layers.Dense(1)#activation='sigmoid'可以不用激活,通过判断大约0还是小于0来判断,激活只是做了一个归一化
])

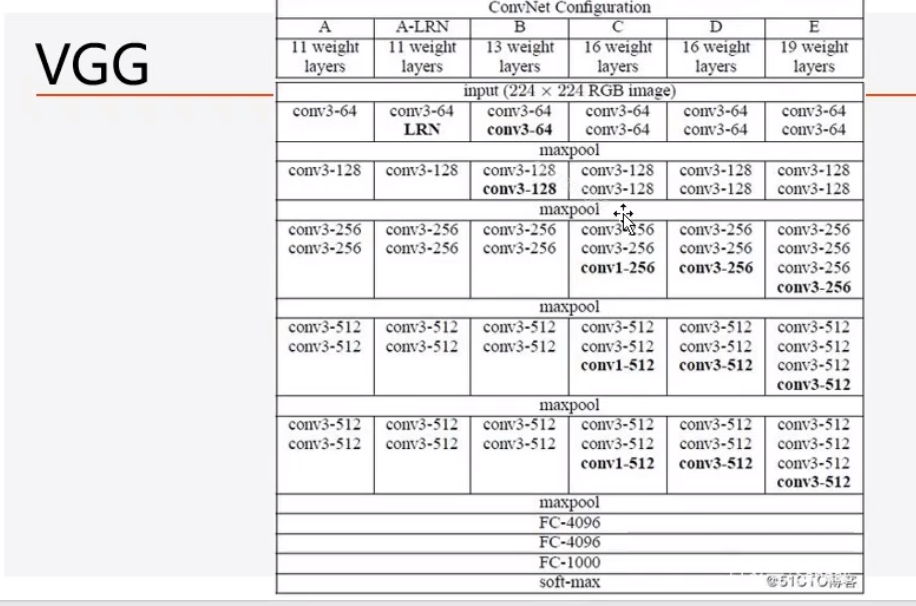
VGG模型

==增加网络容量==

增加网络容量:1.增加网络深度(层增加) 2.增加网络宽度(某一层的fit个数增加,从Con2D(64->2048) 拟合能力增加宽度不如深度的明显, 增加宽度更容易出现过拟合现象

模型查看

1
model.summary()

设置优化器

1
optimizer = tf.keras.optimizers.Adam()#优化器

设置loss、accuracy

1
2
3
4
5
6
#train
epoch_loss_avg = tf.keras.metrics.Mean('train_loss')#用tf.keras.metrics来计算每一个epoch的平均loss
train_accuracy = tf.keras.metrics.Accuracy('')#metrics.Accuracy计算两值是否相等->正确率
#test
epoch_loss_avg_test = tf.keras.metrics.Mean('test_loss')#用tf.keras.metrics来计算每一个epoch的平均loss
test_accuracy = tf.keras.metrics.Accuracy('')#metrics.Accuracy计算两值是否相等->正确率

1. from_logits 的两种使用方法。

在 Keras 的二元交叉熵损失函数(tf.keras.losses.BinaryCrossentropy,下面简称为 bce)中,有 from_logits 这个参数。在使用时需要分下面 2 种情况:

1.如果输入给 bce 的是一个 logit 值(值域范围 [-∞, +∞] ),则应该设置 from_logits=True 。
2.如果输入给 bce 的是一个概率值 probability (值域范围 [0, 1] ),则应该设置为 from_logits=False 。

2. 交叉熵的底层操作。

在计算交叉熵时,实际要经过 2 个步骤:
1.把数值转换为概率值。
2.对这个概率值取对数,得到交叉熵。

3. logit 与 sigmoid 互为反函数。

实际上,logit 是一个函数,并且它和 sigmoid 互为反函数。sigmoid 会把 logit 值转换为 [0, 1] 之间的概率值,而 logit 则会把概率值转换为 [-∞, +∞] 之间的 logit 值。
在 Scipy 中,sigmoid 函数也叫做 expit 函数。下图是 sigmoid 和 logit 函数的对比。关于 sigmoid 函数的更多内容,详见 Scipy 链接 → Scipy 的 sigmoid
原文链接:https://blog.csdn.net/drin201312/article/details/123247057

定义train的每步

==training=True表示将model设置为训练状态==

1
2
3
4
5
6
7
8
9
def train_step(model,images,labels):
with tf.GradientTape() as t:#GradientTape:记录计算的梯度
pred = model(images,training=True)#training=True表示将model设置为训练状态
loss_step = tf.keras.losses.BinaryCrossentropy(from_logits=True)(labels,pred)#计算预测与真实值之间的交叉熵 参数:(正确,预测) from_logits默认为False,输出没有激活则True
grads = t.gradient(loss_step,model.trainable_variables)#t.gradient:梯度(计算损失值与可训练参数之间的梯度) 参数:(loss,可训练参数)
#根据梯度进行优化
optimizer.apply_gradients(zip(grads,model.trainable_variables))#根据计算损失值与可训练参数之间的梯度来优化可训练参数
epoch_loss_avg(loss_step)
train_accuracy(labels,tf.cast(pred>0,tf.int32))#bool判断,>0为1,<0为0

tf.keras.losses.BinaryCrossentropy(from_logits=True)(labels,pred)

计算预测与真实值之间的交叉熵 参数:(正确,预测) from_logits默认为False,输出没有激活则True 如果输入给 bce 的是一个 logit 值(值域范围 [-∞, +∞] ),则应该设置 from_logits=True 。

参数from_logits默认为False,表示输出的logits需要经过激活函数的处理。比如,如果logits经过sigmoid函数处理后,logits的值域为(-1, 1);经过softmax激活函数处理,logits的取值范围为(0, 1)。但是如果没有经过激活函数处理,输出logits的值域为负无穷到正无穷之间。

定义test的每步

==training=False表示将model设置为非训练状态==

1
2
3
4
5
def test_step(model,images,labels):
pred = model(images,training=False)#model.predict(images) ;model()传入数据会进行训练;training=False表示将model设置为非训练状态
loss_step = tf.keras.losses.BinaryCrossentropy(from_logits=True)(labels,pred)#计算预测与真实值之间的交叉熵 参数:(正确,预测) from_logits默认为False,输出没有激活则True
epoch_loss_avg_test(loss_step)
test_accuracy(labels,tf.cast(pred>0,tf.int32))#bool判断,>0为1,<0为0

记录每个epoch中train、test的accuracy与loss

1
2
3
4
5
6
#train
train_loss_results = []
train_acc_results = []
#test
test_loss_results = []
test_acc_results = []

设置epoch次数

1
num_epochs = 30#定义训练epoch次数

设置训练函数

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
for epoch in range(num_epochs):
#train
for imgs_,labels_ in train_image_ds:
train_step(model,imgs_,labels_)#一步训练
print('.',end='')
print()

train_loss_results.append(epoch_loss_avg.result())
train_acc_results.append(train_accuracy.result())

#test
for imgs_,labels_ in test_image_ds:
test_step(model,imgs_,labels_)
test_loss_results.append(epoch_loss_avg_test.result())
test_acc_results.append(test_accuracy.result())

print('#Epoch:{},loss:{:.3f},accuracy:{:.3f}#test_loss:{:.3f},test_accuracy:{:.3f}#'.format(
epoch+1,
epoch_loss_avg.result(),
train_accuracy.result(),
epoch_loss_avg_test.result(),
test_accuracy.result()
))

epoch_loss_avg.reset_states()#是累计的需要重置
train_accuracy.reset_states()#是累计的需要重置
epoch_loss_avg_test.reset_states()#是累计的需要重置
test_accuracy.reset_states()#是累计的需要重置