tf.keras概述
pandas的csv
data数据
1 | data = pd.DataFrame({'Education': [10.000000, 10.401338, 10.842809, 11.244147, 11.645449, 12.086957, 12.048829, 12.889632, 13.290970, 13.732441, 14.133779, 14.635117, 14.978589, 15.377926, 15.779264, 16.220736, 16.622074, 17.023411, 17.464883, 17.866221, 18.267559, 18.709030, 19.110368, 19.511706, 19.913043, 20.354515, 20.755853, 21.167191, 21.598662, 22.000000], |
csv的写入
1 | data.to_csv('Incomel.csv') |
csv的读取
1 | data = pd.read_csv('./Incomel.csv') |
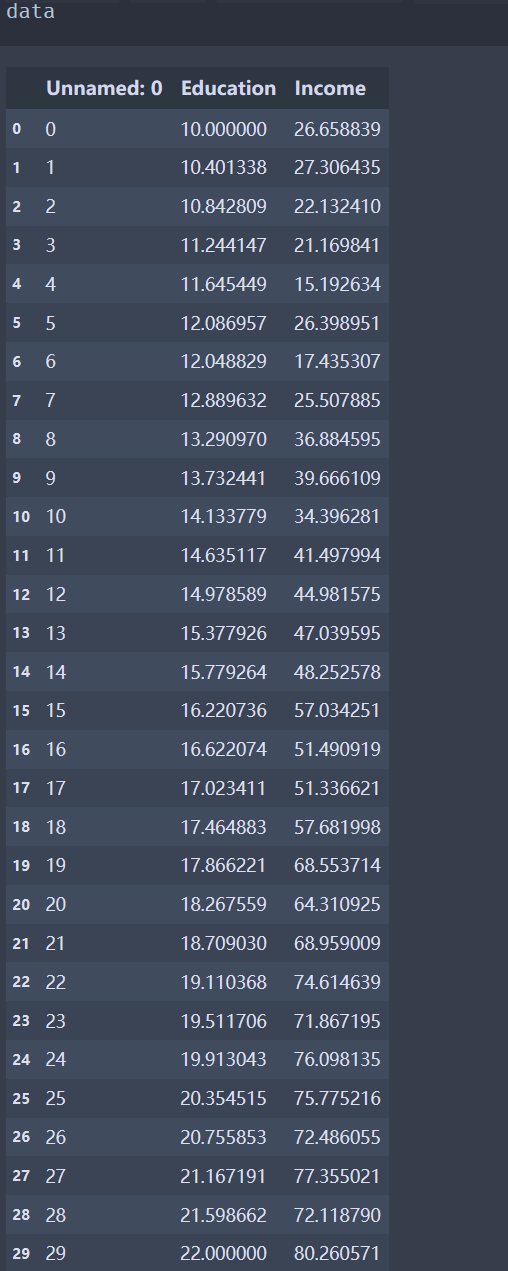
散点图绘制
import matplotlib.pyplot as plt %matplotlib inline
1 | plt.scatter(data.Education,data.Income) |
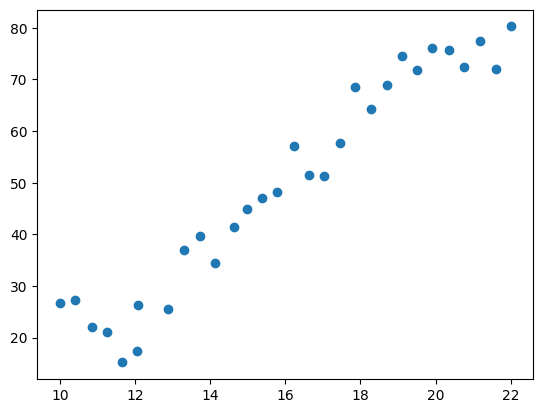
plt.scatter( )绘制散点图
matplotlib.pyplot.scatter(x, y, s=None, c=None, marker=None, cmap=None, norm=None, vmin=None,
vmax=None, alpha=None, linewidths=None, verts=None, edgecolors=None, hold=None, data=None, **kwargs)x, y → 散点的坐标
s → 散点的面积
c → 散点的颜色(默认值为蓝色,’b’,其余颜色同plt.plot( ))
marker → 散点样式(默认值为实心圆,’o’,其余样式同plt.plot( ))
alpha → 散点透明度([0, 1]之间的数,0表示完全透明,1则表示完全不透明)
linewidths →散点的边缘线宽
edgecolors → 散点的边缘颜色这里为了生成点的坐标,用到了numpy中的随机数生成器 np.random.rand(d0, d1, …, dn)
rand( )函数根据给定维度生成[0,1)之间的随机数据(包含0,不包含1)
dn表示生成数据的维度
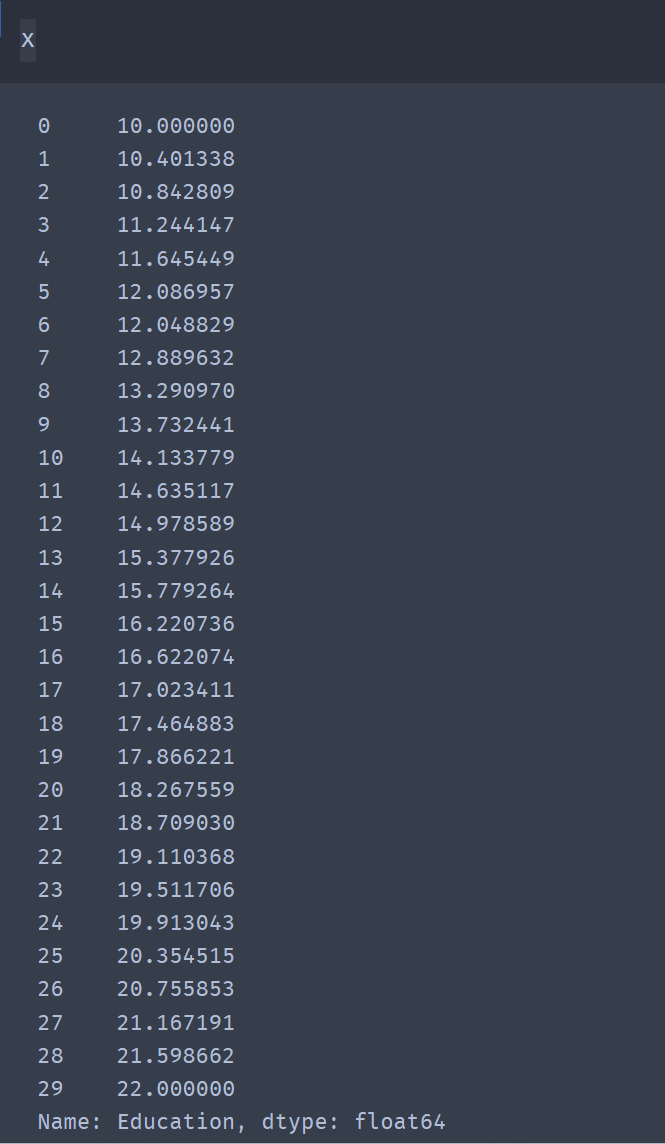
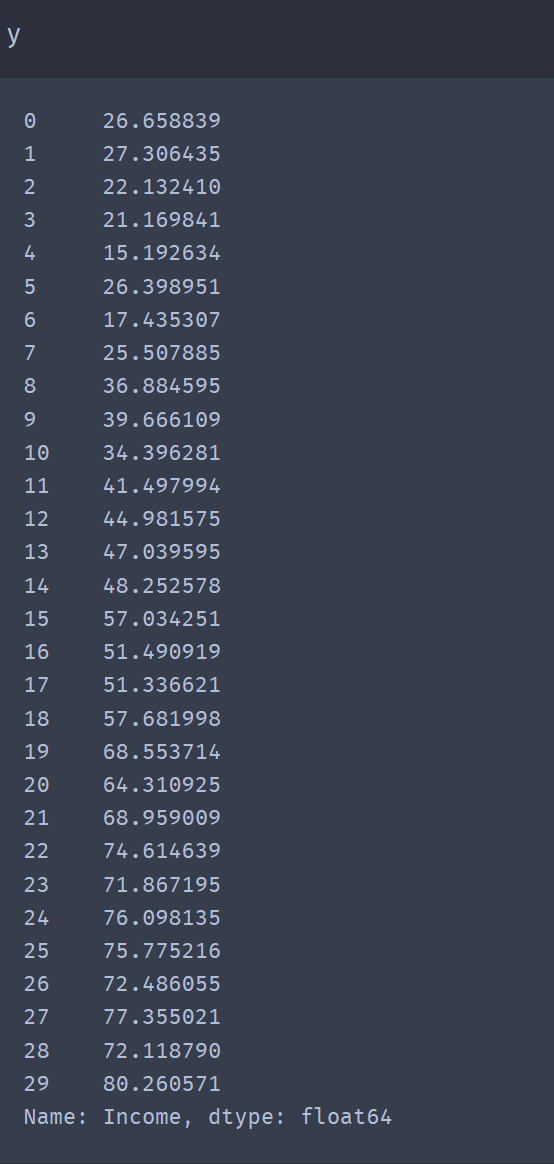
数据对应
1 | x = data.Education |
模型搭建
1 | model = tf.keras.Sequential()#Sequential模型 |
模型优化器等选择
1 | model.compile(optimizer='adam',#adam位优化算法,学习速率默认0.001 |
模型训练
1 | history = model.fit(x,y,epochs=5000)#训练5000次 |
模型预测
1 | model.predict(x) #将原本x输入进去,观察输出值与原y值对比 |
1 | pd.Series([20]) |
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 YuKiFuHaNeの博客!
相关推荐

2023-07-14
200 种鸟类分类(多分类问题)
import tensorflow as tffrom tensorflow import keras import matplotlib.pyplot as plt %matplotlib inline import glob import numpy as np 打印Tensorflow版本1print('Tensorflow version:{}'.format(tf.__version__)) 打印是否能使用GPU加速运行1print(tf.test.is_gpu_available()) 获取图片路径1imgs_path = glob.glob("birds/*/*.jpg") 从路径中截取鸟类名称123img_p.split('\\')[1].split('.')[1]all_labels_name = [img_p.split('\\')[1].split('.')[1] for img_p in imgs_path]l...

2023-07-14
多层感知器
import tensorflow as tfimport pandas as pd import numpy as np import matplotlib.pyplot as plt %matplotlib inline 读取csv数据1data = pd.read_csv('Advertising.csv') 12#打印数据data.head() #head打印前5行 Unnamed: 0 TV radio newspaper sales 0 1 230.1 37.8 69.2 22.1 1 2 44.5 39.3 45.1 10.4 2 3 17.2 45.9 69.3 9.3 3 4 151.5 41.3 58.5 18.5 4 5 180.8 10.8 58.4 12.9 散点图绘制1plt.scatter(data.TV,data.sales) 1plt.scatter(data.radio,data.sales) 1plt.scatter(data.newspaper,data.sales) ...

2023-07-14
解决过拟合问题:Dropout 层与 L1/L2 正则化
import tensorflow as tf from tensorflow import keras from tensorflow.keras import layers import matplotlib.pyplot as plt %matplotlib inline 加载Tensorflow的dataset数据123data = keras.datasets.imdb#电影评论数据max_word = 10000(x_train,y_train),(x_test,y_test) = data.load_data(num_words=max_word) 文本训练场密集向量12x_train = keras.preprocessing.sequence.pad_sequences(x_train,300)x_test = keras.preprocessing.sequence.pad_sequences(x_test,300) 创建模型1234567model = keras.models.Sequential()model.add(layers.Embeddi...

2023-07-14
叶子实例分类
import tensorflow as tf from tensorflow import keras from tensorflow.keras import layers import numpy as np import pandas as pd import matplotlib.pyplot as plt %matplotlib inlinefrom sklearn.model_selection import train_test_split conda install scikit-learn pandas读取树叶csv纹理数据1data = pd.read_csv('./leaf/train.csv') 查看每列的数据类型1data.info() 12345<class 'pandas.core.frame.DataFrame'>RangeIndex: 990 entries, 0 to 989Columns: 194 entries, id to texture64dtypes: float6...
2023-07-14
TensorBoard 可视化
Tensorboard的导入 1234567891011import oslog_dir = os.path.join('logs',datetime.datetime.now().strftime("%Y%m%d-%H%M%S")) tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir,histogram_freq=1)#histogram_freq: 对于模型中各个层计算激活值和模型权重直方图的频率(训练轮数中)。 如果设置成 0 ,直方图不会被计算。对于直方图可视化的验证数据(或分离数据)一定要明确的指出。model.fit(dataset, epochs=5, steps_per_epoch=60000//128, validation_data=test_dataset, validation_steps=10000//128, callbacks=[tensorboa...
2023-07-14
RNN 序列预测实例:空气污染预测
from tensorflow import keras from tensorflow.keras import layers import pandas as pd import numpy as np import matplotlib.pyplot as plt %matplotlib inlineimport datetime pandas读取csv文件1data = pd.read_csv('./PRSA_data_2010.1.1-2014.12.31.csv') 1data.head() No year month day hour pm2.5 DEWP TEMP PRES cbwd Iws Is Ir 0 1 2010 1 1 0 NaN -21 -11.0 1021.0 NW 1.79 0 0 1 2 2010 1 1 1 NaN -21 -12.0 1020.0 NW 4.92 0 0 2 3 2010 1 1 2 NaN -21 -11.0 1019.0 NW 6.71 0 0 3 4 2010 1 1 ...


