自编码器与变分自编码器概念
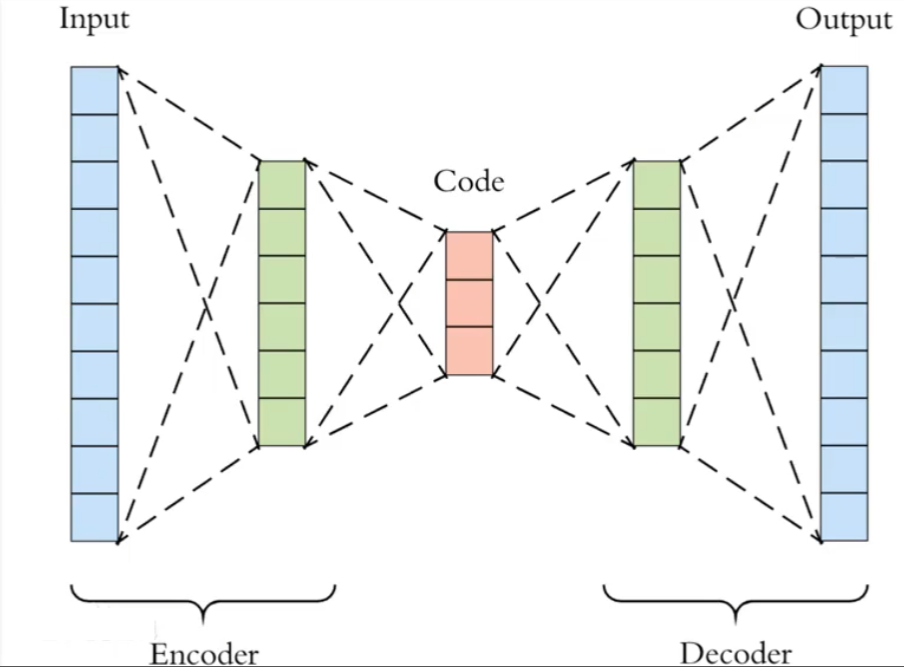
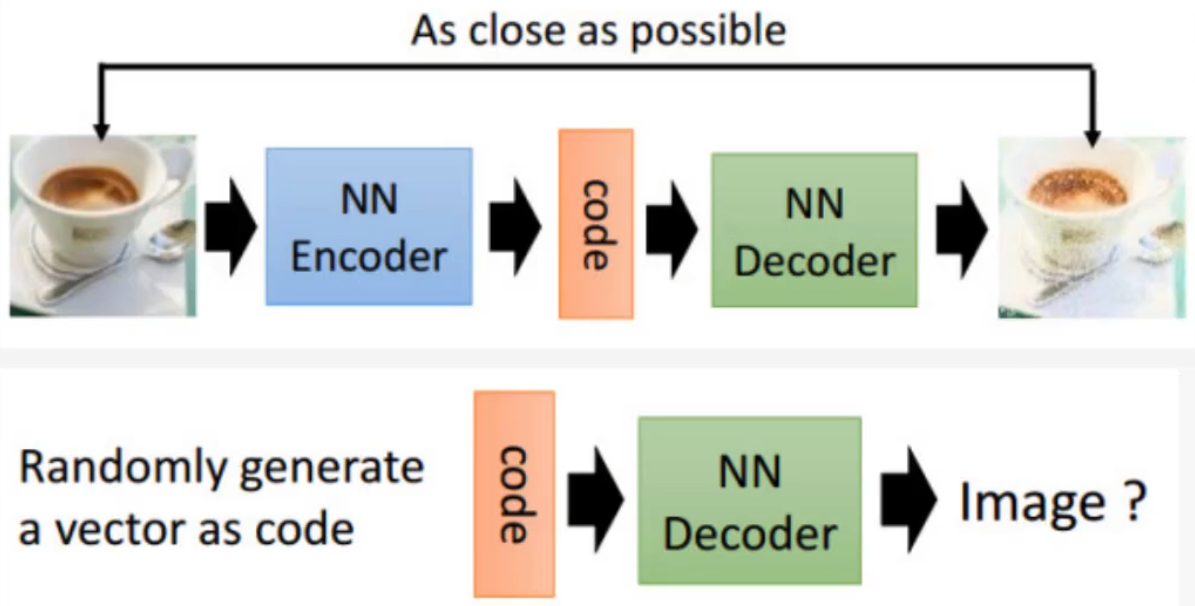
(1)自动编码器是数据相关的,这意味着自动编码器只能压缩那些与训练数据类似的数据。
(2)自动编码器是有损的,与无损压缩算法不同。
(3)自动编码器是从数据样本中自动学习的
自编码器应用
- 数据去噪
- 降维
- 图像生成
变分自编码器(VAE)
变分自编码器(VariationalAuto-Encoders,VAE)作为深度生成模型的一种形式,是于2014年提出的生成式网络结构。它以概率的方式描述对潜在空间的观察,在数据生成方面表现出了巨大的应用价值。
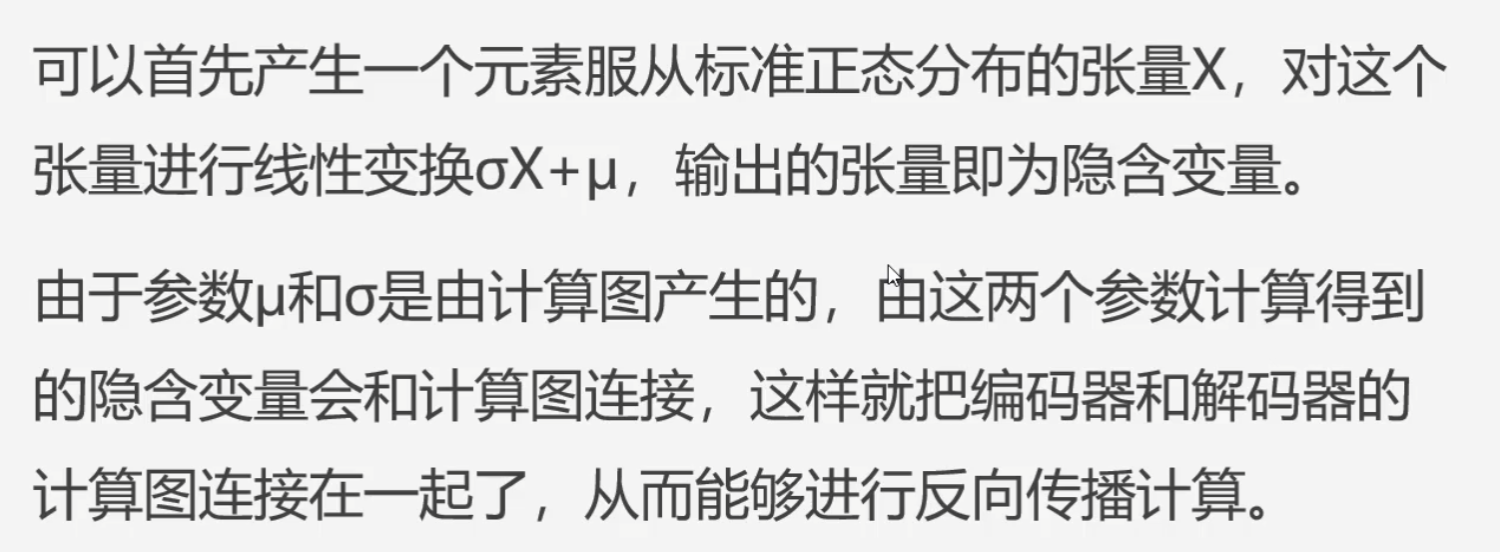
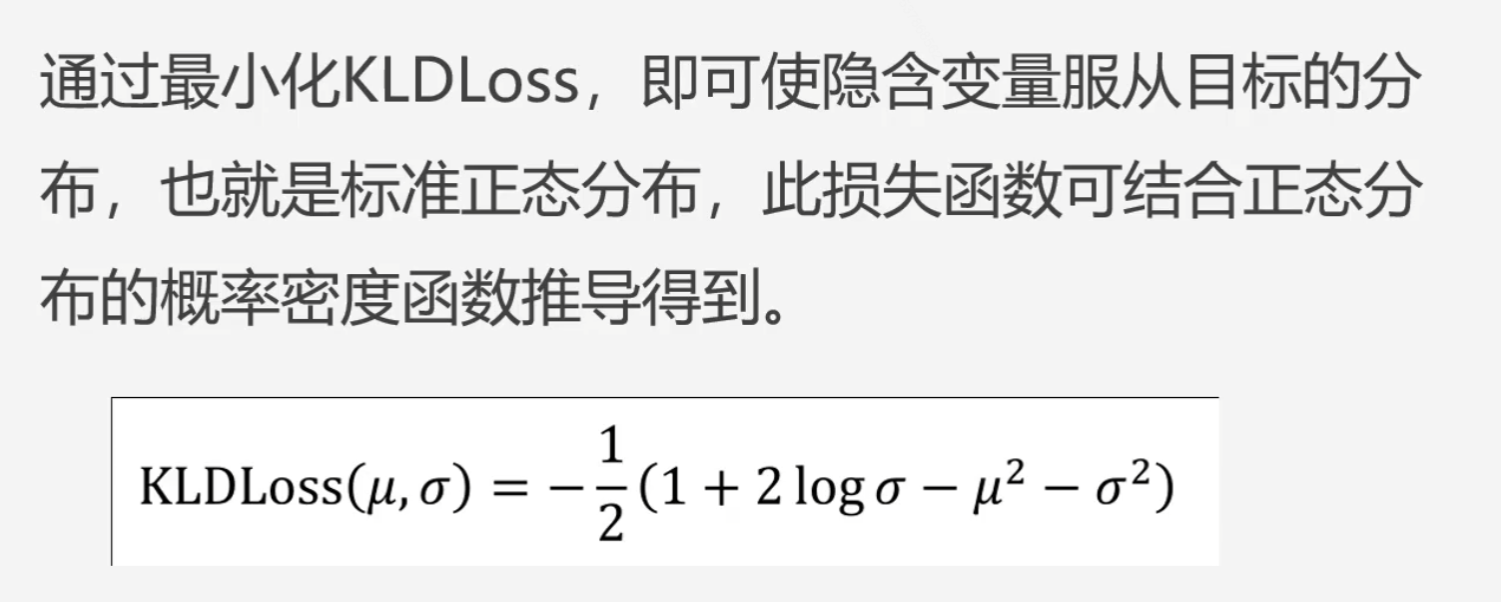
变分编码器可以随机生成隐含变量
提高网络的泛化能力,比普通的自动编码器要好
缺点就是生成的图片会有点模糊
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 YuKiFuHaNeの博客!
相关推荐

2023-07-14
变分自编码器
import tensorflow as tf import numpy as np import matplotlib.pyplot as plt %matplotlib inline 加载手写数据集1(train_image,_),_ = tf.keras.datasets.mnist.load_data() 模型架构1.编码器 -> u,var 2.u,var -> 隐含变量 3.隐含变量 -> 重构图像 数据归一化1train_image = train_image/255 数据shape12train_image.shape(60000, 28, 28) 数据扁平化1train_image = train_image.reshape(-1,28*28)#扁平化 数据shape12train_image.shape(60000, 784) 转换数据类型1train_image = train_image.astype(np.float32)#转换类型 创建dataset1dataset = tf.data.Dataset.from_ten...

2023-07-14
基本自编码器
import tensorflow as tf import matplotlib.pyplot as plt 查看Tensorflow版本1tf.__version__ 加载数据集1(x_train,_),(x_test,_) = tf.keras.datasets.mnist.load_data() 扁平化12x_train = x_train.reshape(x_train.shape[0],-1)#-1 表示自动计算x_test = x_test.reshape(x_test.shape[0],-1) 123x_train.shape,x_test.shape((60000, 28, 28), (10000, 28, 28))((60000, 784), (10000, 784)) 归一化12x_train = tf.cast(x_train,tf.float32)/255x_test = tf.cast(x_test,tf.float32)/255 设置输入、输出、压缩大小123input_size = 784hidden_size = 32output_si...
2023-07-14
激活函数与梯度消失详解
本文整理/翻译自AYOOSH KATHURIA的博客:Intro to Optimization in Deep Learning: Vanishing Gradients and Choosing the Right Activation Function, 整理过程中加入了一些自己的观点,欢迎讨论/指正/点赞! 12345678910111213#***文章大纲***#1. Sigmoid 和梯度消失(Vanishing Gradients) 1.1 梯度消失是如何发生的? 1.2 饱和神经元(Saturated Neurons)2. ReLU 和神经元“死亡”(dying ReLU problem) 2.1 ReLU可以解决梯度消失问题 2.2 单侧饱和 2.3 神经元“死亡”(dying ReLU problem) 2.4 梯度更新方向的锯齿路径3. LeakyReLU和PReLU 3.1 LeakyReLU可以解决神经元”死亡“问题4. 集大成者ELU(Exponential Linear Un...
2025-05-06
CVAT搭建
Ubuntu 22.04/20.04(x86_64/amd64) 打开终端窗口。如果你不知道如何在 Ubuntu 上打开终端窗口,请阅读答案。 在终端窗口中输入以下命令来安装 Docker 和 Docker Compose。更多说明请参见此处。 123456789101112131415sudo apt-get updatesudo apt-get --no-install-recommends install -y \ apt-transport-https \ ca-certificates \ curl \ gnupg-agent \ software-properties-commoncurl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo apt-key add -sudo add-apt-repository \ "deb [arch=amd64] https://download.docker.com/linux/ubuntu \ $(lsb_relea...

2023-07-14
U-Net 模型概念
语义分割的UNET网络结构Unet是2015年诞生的模型,它几乎是当前segmentation项 目中应用最广的模型。 Unet能从更少的训练图像中进行学习。 当它在少于 40 张图 的生物医学数据集上训练时,IOU 值仍能达到 92%。 U-net网络非常简单,前半部分作用是特征提取,后半部分是上采样。 在一些文献中也把这样的结构叫做编码器-解码器结构。 由于此网络整体结构类似于大写的英文字母U,故得名U-net。 1234U-net与其他常见的分割网络有一点非常不同的地方:U-net采用了完全不同的特征融合方式:拼接(tf.concat)U-net采用将特征在channel维度拼接在一起,形成更厚的特征。而FCN融合时使用的对应点相加,并不形成更厚的特征。 语义分割网络在特征融合两种办法语义分割网络在特征融合时有两种办法: FCN式的对应点相加,对应于TensorFlow中的tf.add()函数; U-net式的channel维度拼接融合,对应于TensorFlow的 tf.concat()函数,比较占显存。 UNET网络结构特点1、网络对图像特征的多尺度特征...
2023-07-14
TensorBoard 可视化
Tensorboard的导入 1234567891011import oslog_dir = os.path.join('logs',datetime.datetime.now().strftime("%Y%m%d-%H%M%S")) tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir,histogram_freq=1)#histogram_freq: 对于模型中各个层计算激活值和模型权重直方图的频率(训练轮数中)。 如果设置成 0 ,直方图不会被计算。对于直方图可视化的验证数据(或分离数据)一定要明确的指出。model.fit(dataset, epochs=5, steps_per_epoch=60000//128, validation_data=test_dataset, validation_steps=10000//128, callbacks=[tensorboa...



