多层感知器
import tensorflow as tfimport pandas as pd import numpy as np import matplotlib.pyplot as plt %matplotlib inline
读取csv数据
1 | data = pd.read_csv('Advertising.csv') |
1 | #打印数据 |
| Unnamed: 0 | TV | radio | newspaper | sales | |
|---|---|---|---|---|---|
| 0 | 1 | 230.1 | 37.8 | 69.2 | 22.1 |
| 1 | 2 | 44.5 | 39.3 | 45.1 | 10.4 |
| 2 | 3 | 17.2 | 45.9 | 69.3 | 9.3 |
| 3 | 4 | 151.5 | 41.3 | 58.5 | 18.5 |
| 4 | 5 | 180.8 | 10.8 | 58.4 | 12.9 |
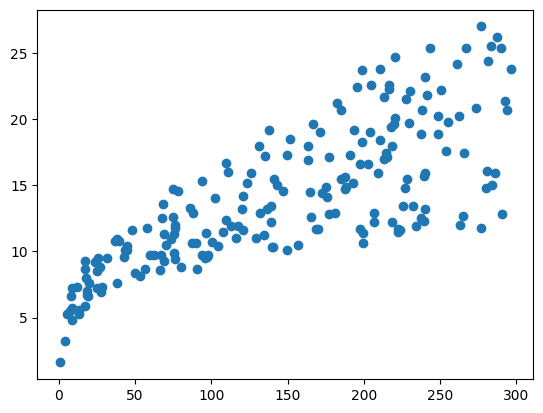
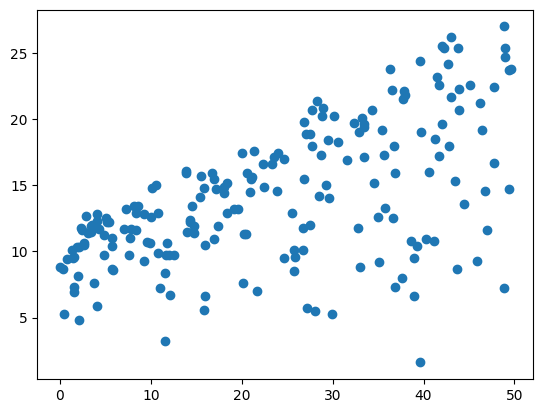
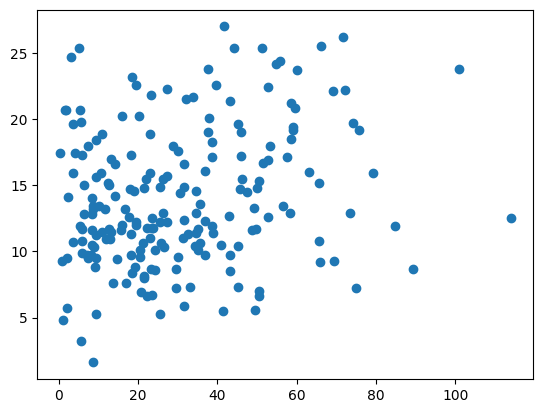
散点图绘制
1 | plt.scatter(data.TV,data.sales) |
1 | plt.scatter(data.radio,data.sales) |
1 | plt.scatter(data.newspaper,data.sales) |
数据处理
1 | x = data.iloc[:,1:-1]#取所有x行,列取1到倒数第一个 |
模型搭建
1 | model = tf.keras.Sequential([tf.keras.layers.Dense(10,input_shape=(3,),activation='relu'),#activation激活函数#Dense(隐藏层,层数越大拟合越强) |
模型情况
1 | model.summary() |
模型优化函数等设置
1 | model.compile(optimizer='adam', |
模型训练
1 | model.fit(x,y,epochs=100) |
模型测试
1 | test = data.iloc[:10,1:-1] |
1 | test |
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 YuKiFuHaNeの博客!
相关推荐

2023-07-14
ResNet残差模块
import tensorflow as tf 定义ResNetBlock1234567891011121314151617181920212223class ResNetBlock(tf.keras.layers.Layer): def __init__(self,units): super(ResNetBlock,self).__init__() self.conv1 = tf.keras.layers.Conv2D(units, kernel_size=3, padding='same', use_bias=False) self.bn1 = tf.keras.layers.BatchNormalization()#批标准化 s...

2023-07-14
逻辑回归实现
import tensorflow as tfimport pandas as pd import numpy as np import matplotlib.pyplot as plt %matplotlib inline csv数据读取1data = pd.read_csv('./credit-a.csv',header=None) 数据统计1234data.iloc[:,-1].value_counts() 1 357-1 296Name: 15, dtype: int64 数据处理12x = data.iloc[:,:-1]y = data.iloc[:,-1].replace(-1,0) 模型搭建1234model = tf.keras.Sequential()model.add(tf.keras.layers.Dense(4,input_shape=(15,),activation='relu'))#第一层model.add(tf.keras.layers.Dense(4,activation='r...
2023-07-14
卷积去噪自编码器的实现
import tensorflow as tf import matplotlib.pyplot as plt import numpy as np 查看tensorflow版本1tf.__version__ 导入mnist数据集1(x_train,_),(x_test,_) = tf.keras.datasets.mnist.load_data() 查看数据维度1x_train.shape,x_test.shape 对数据最后一个维度进行扩展12x_train = np.expand_dims(x_train, -1)x_test = np.expand_dims(x_test, -1) x_train.shape,x_test.shape 1((60000, 28, 28, 1), (10000, 28, 28, 1)) 数据归一化12x_train = tf.cast(x_train,tf.float32)/255x_test = tf.cast(x_test,tf.float32)/255 噪声的添加123factor = 0.5 #增加噪声多少x_train...

2023-07-14
图像定位
import tensorflow as tf import matplotlib.pyplot as plt %matplotlib inline from lxml import etree from matplotlib.patches import Rectangle import numpy as np import glob 查看Tensorflow版本1tf.__version__ 查看是否支持GPU加速1tf.test.is_gpu_available() 创建输入管道读取所有图片1images = glob.glob('./images/*.jpg') 读取xmls标注文件1xmls = glob.glob('./annotations/xmls/*.xml') 对读取的图片jpg与xmls进行名称提取12xmls_names = [x.split('\\')[-1].split('.xml')[0] for x in xmls]images_names = [x.spli...

2023-07-14
Softmax多分类
import pandas as pd import numpy as np import matplotlib.pyplot as plt %matplotlib inline 加载fashion_mnist数据集1(train_image,train_label),(test_image,test_label) = tf.keras.datasets.fashion_mnist.load_data() 归一化123#归一化处理,从0~1train_image = train_image /255test_image = test_image /255 模型建立1234model = tf.keras.Sequential()model.add(tf.keras.layers.Flatten(input_shape=(28,28)))#28*28的图片大小model.add(tf.keras.layers.Dense(128,activation='relu'))model.add(tf.keras.layers.Dense(10,activation...
2023-07-14
基本去噪自编码器的实现
import tensorflow as tf import matplotlib.pyplot as plt import numpy as np 查看tensorflow版本1tf.__version__ 导入mnist数据集1(x_train,_),(x_test,_) = tf.keras.datasets.mnist.load_data() 查看数据维度1x_train.shape,x_test.shape 对数据进行reshape 28*28->78412x_train = x_train.reshape(x_train.shape[0], -1)x_test = x_test.reshape(x_test.shape[0], -1) 数据归一化12x_train = tf.cast(x_train,tf.float32)/255x_test = tf.cast(x_test,tf.float32)/255 噪声的添加123factor = 0.5 #增加噪声多少x_train_noise = x_train + factor*np.random.n...


